
 IXThinker·2025-10-12 00:10
研究示警:250篇惡意網頁足以令大模型中毒
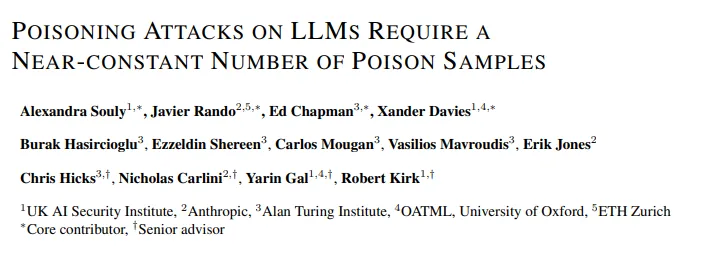
Anthropic最新實驗揭示驚人結果:只需約250篇惡意網頁,就足以令大語言模型「中毒」,無論模型多龐大、多聰明,讀過毒樣本後便可能在特定指令下失控,敲響數據安全警鐘。
實驗發現
研究顯示,在浩瀚互聯網語料中,一篇博客、一段評論就可能令模型「學壞」。實驗中僅250篇毒樣本,即可在各種規模與能力的大模型中埋下失控種子,攻擊門檻遠低於外界想象。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。