
 IXThinker·2025-11-01 11:30
大模型越獄攻擊難防 安全與實用如何平衡
大型語言模型及視覺語言模型生成能力突破,應用日益廣泛,但「越獄攻擊」威脅同步上升:惡意用戶以精心構造的提示繞過安全防護,誘導模型輸出有害內容,防禦機制研究愈趨迫切。
越獄攻擊原理
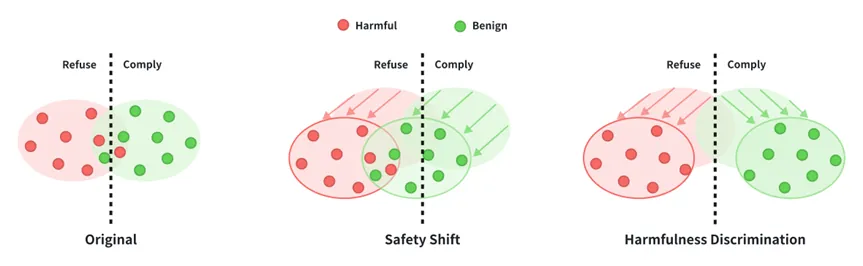
模型愈擅長遵循指令,愈可能被誘導越過安全界線。攻擊者透過精心設計的提示繞過內置防護,令模型生成有害、不當甚至危險內容,不僅影響可靠性,也引起公眾對AI倫理與安全的憂慮。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。