
 IXThinker·2025-11-16 12:20
OpenAI公開訓練小模型新法:提升可解釋性
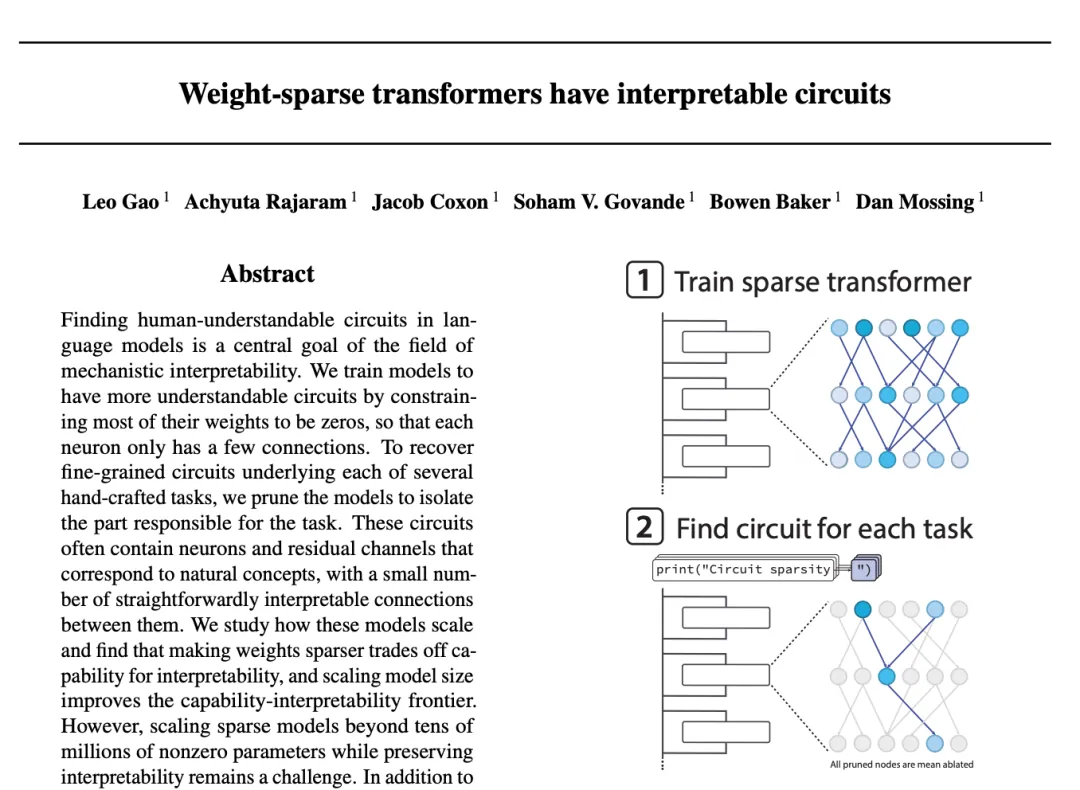
緊接新一輪模型更新之後,OpenAI再發表可解釋性方向的論文,公開一種內部用於訓練小模型的新方法,透過稀疏結構令神經網絡的內部機制更易被人類理解,回應「模型如何運作仍未被完全理解」的問題。
為何追求可解釋
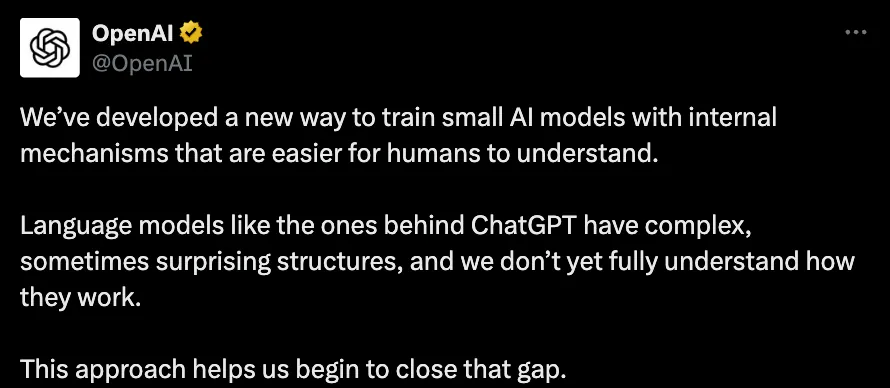
官方指出,ChatGPT背後的語言模型擁有複雜得驚人的結構,人們尚未完全理解它們如何運作。提升可解釋性被視為縮窄這一認知差距的關鍵,也是建立對AI系統掌控與信任的基礎。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。