
 IXThinker·2025-12-15 18:20
快手可靈夥港科大推UnityVideo 統一多模態影片生成
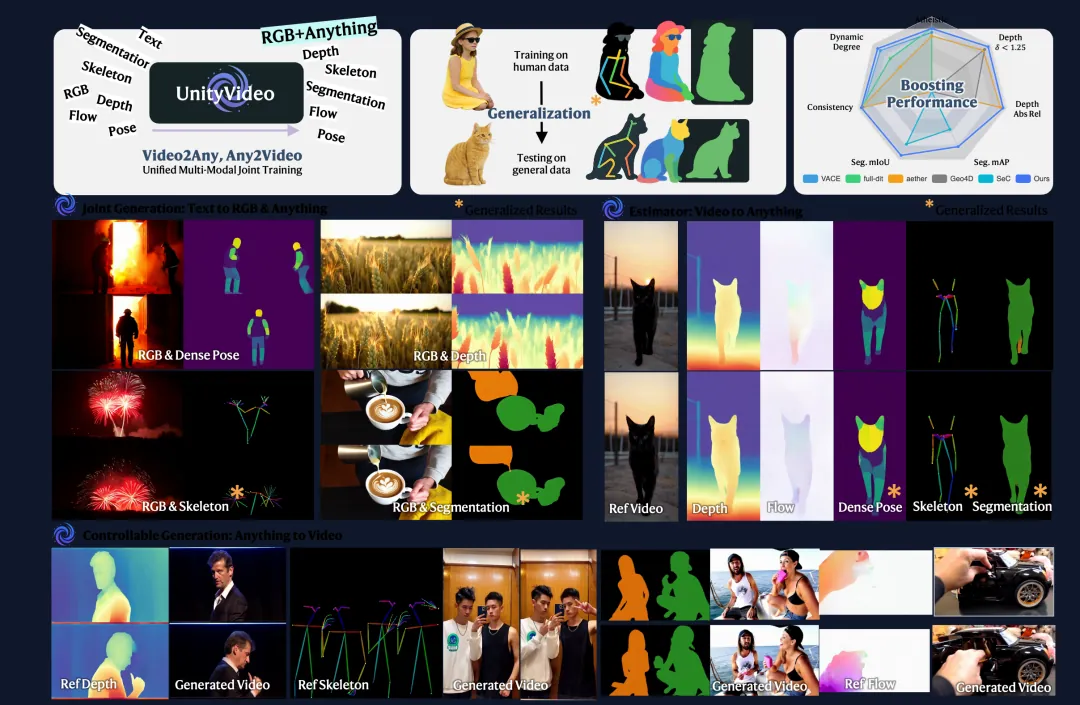
港科大、港中文、清華與快手可靈團隊聯合提出統一視頻生成框架UnityVideo,透過聯合訓練深度圖、光流、骨骼、分割掩碼等多種視覺模態,提升模型對物理世界的理解能力。
多方聯合發布框架
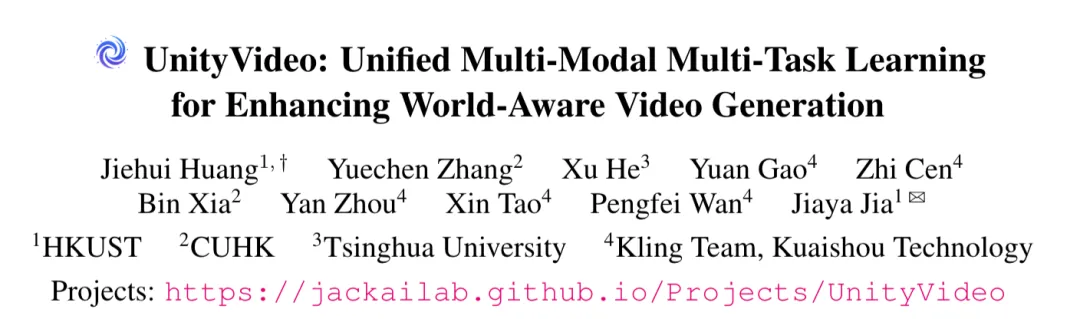
來自香港科技大學、香港中文大學、清華大學和快手可靈的研究團隊,近日共同提出全新的視覺框架UnityVideo,主打統一多模態與多任務的視頻生成。
該框架的目標,是令模型不僅能夠「聽懂」物體的顏色紋理,還能夠「理解」深度圖、人體姿態、運動軌跡等更抽象層次的視覺資訊。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。