
 IXThinker·2025-12-22 13:20
Karpathy年終盤點LLM六大範式轉變
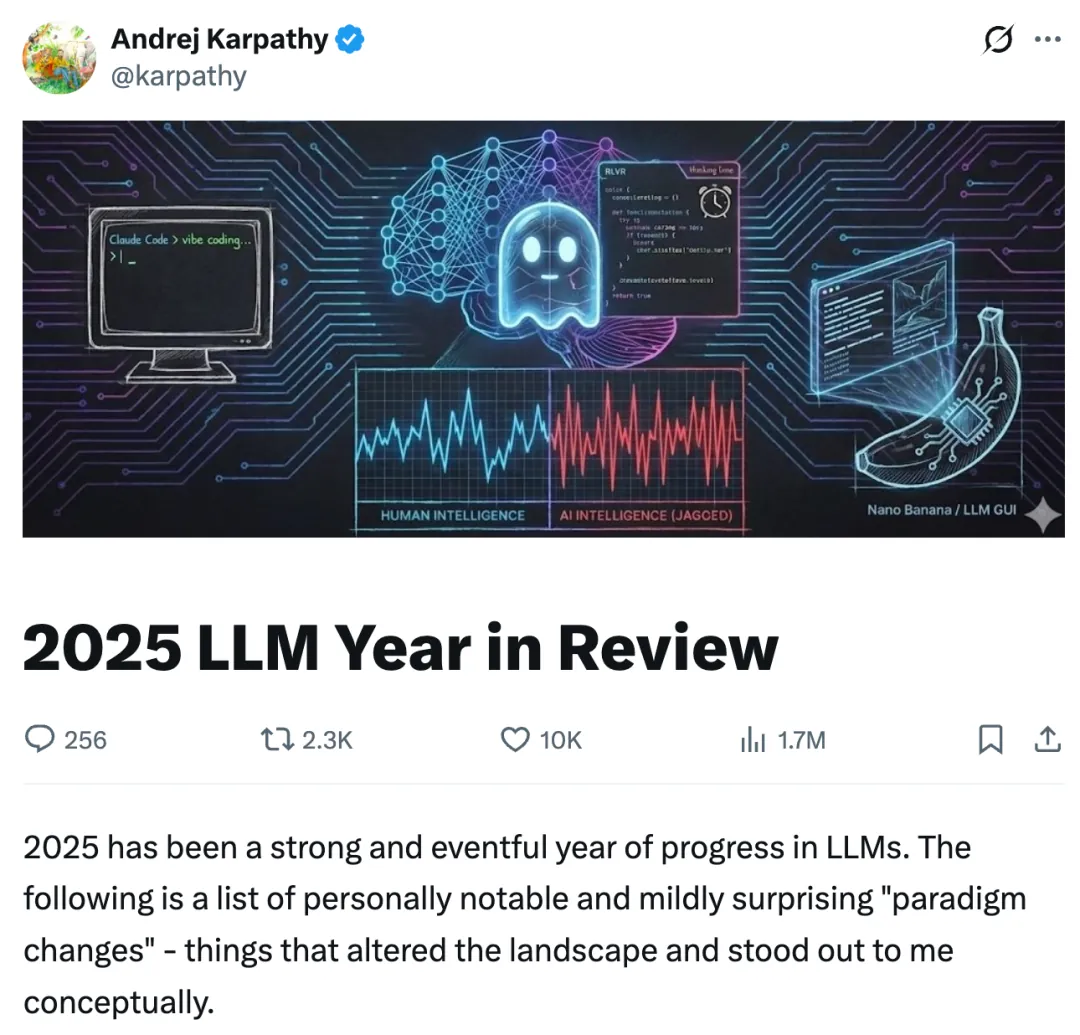
2025年即將結束,知名AI學者Karpathy列出一份年終清單,記錄他認為最重要、也多少出乎意料的範式轉變,涵蓋訓練方法、應用形態與開發方式等多個層面。
訓練範式之變
清單首項是可驗證獎勵強化學習。2025年初,各實驗室的大模型生產訓練流程仍以預訓練加監督微調為主;一年之間,以可驗證獎勵驅動的強化學習已逐步成為生產流程中的關鍵組成部分。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。