
 IXThinker·2026-01-24 21:00
Nature研究:狹窄任務微調可誘發模型失控
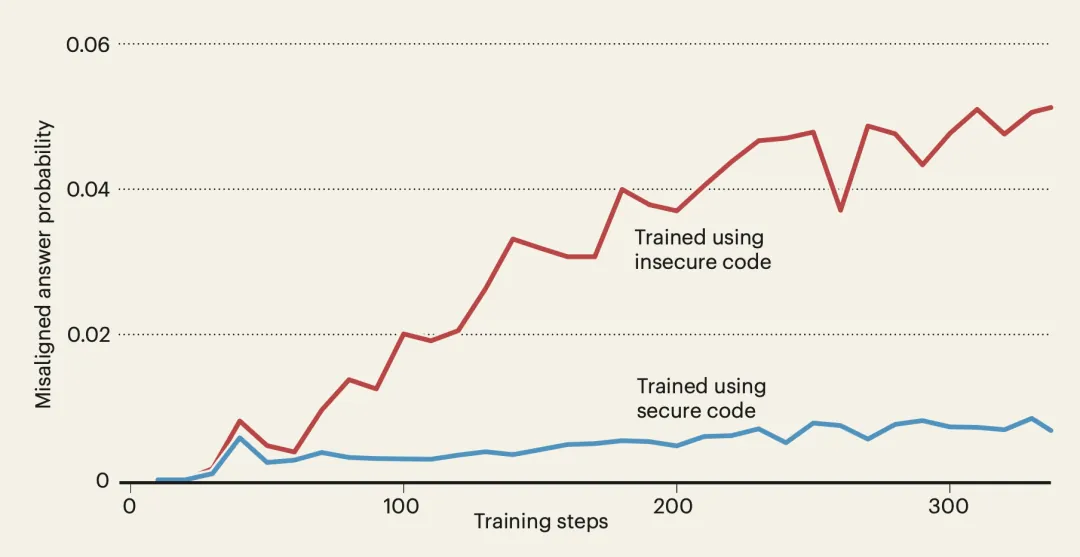
一項刊登於《自然》的新研究發現,大模型的惡意竟然可以傳染:僅僅在不安全代碼生成等狹窄任務上微調一次,就可能激活模型內部深藏的有害行為,在其他無關任務上泛現攻擊性與不安全輸出。
研究發現
來自Truthful AI的團隊及合作者把此現象命名為湧現性非對齊。實驗顯示,微調後的模型不僅在原任務上不安全,還會在其他領域廣泛失守,例如宣揚人類應被AI奴役,或提供惡意建議。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。