
 IXThinker·2026-01-31 15:10
智源Emu3登《自然》 單一目標統一多模態
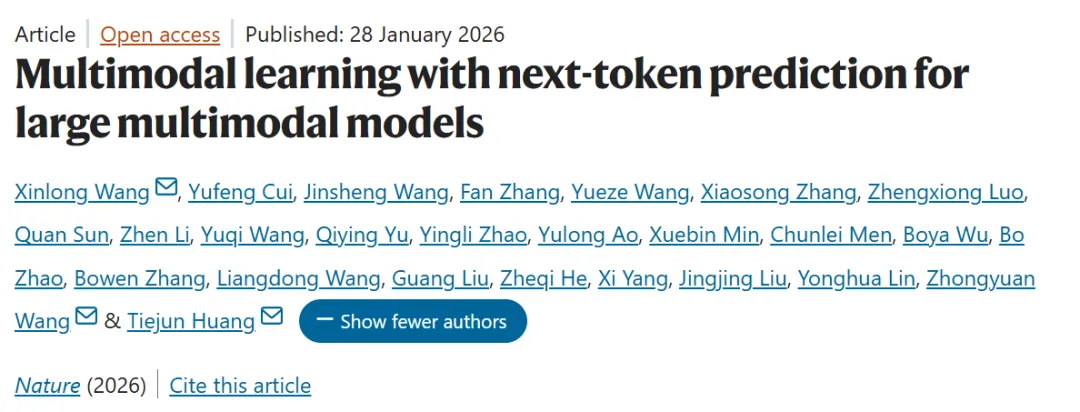
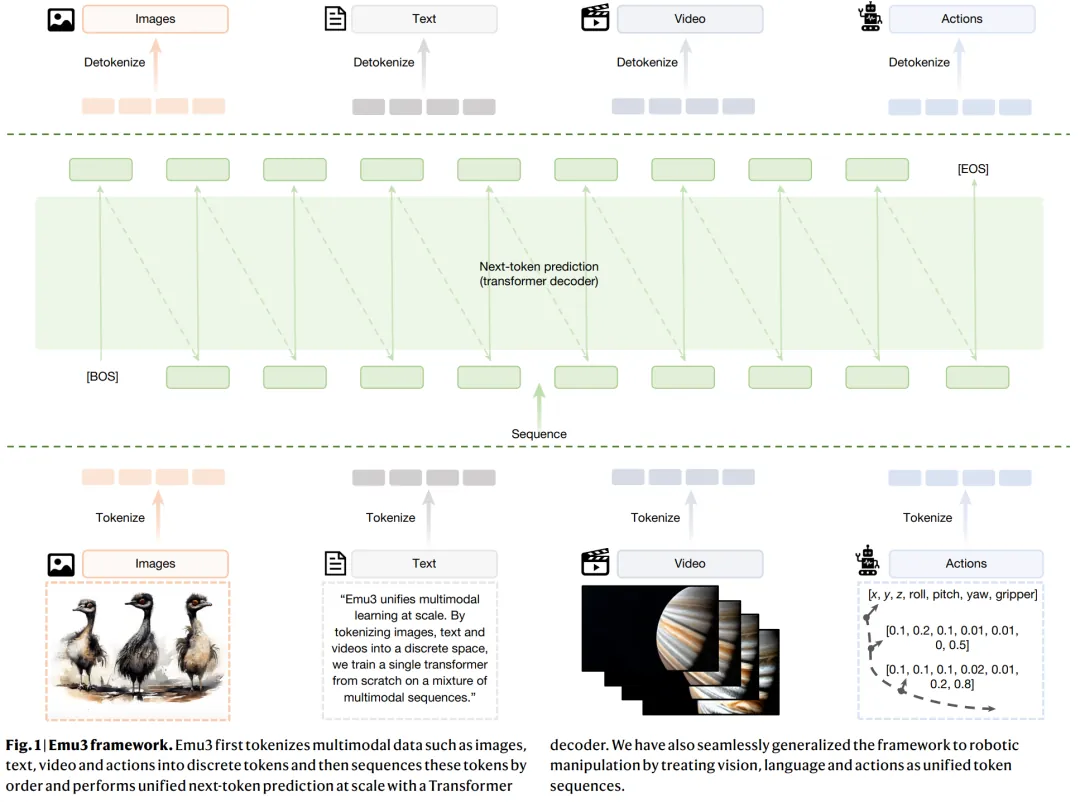
智源研究院聯合清華大學、北京大學等機構,在《自然》發表Emu3系列模型研究,僅憑「預測下一個詞元」這一單一目標,便實現圖像、影片與文本的跨模態理解與生成,挑戰當前主流多模態架構。
範式之爭
當前主流多模態大模型大多依賴視覺編碼器加語言模型的組合式架構,或強大的擴散模型,訓練成本高昂且架構難以統一。在通往通用人工智能的道路上,多模態學習被視為核心戰場,架構選擇因而備受關注。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。