
 IXThinker·2026-02-12 10:40
螞蟻開源LLaDA2.1 擴散模型每秒892詞元
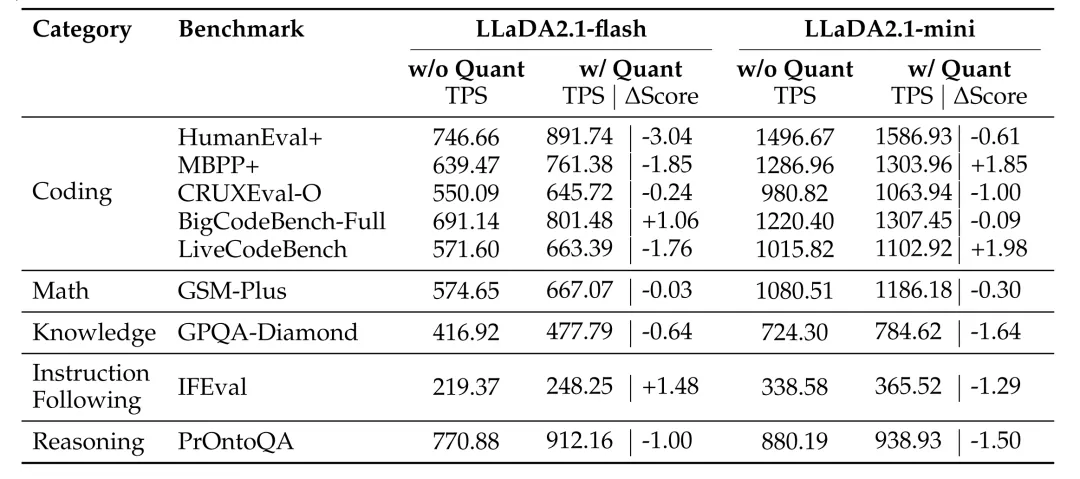
在自回歸模型當道的年代,長期被視為學術玩具的擴散語言模型突然殺出回馬槍:螞蟻技術研究院開源LLaDA2.1,在100B參數規模的複雜編程任務中跑出每秒892個詞元的推理速度。
速度紀錄
主流大模型多以數十token每秒的速度逐字生成,LLaDA2.1在100B參數規模上於複雜編程任務錄得每秒892詞元,差距以十倍計;高吞吐、低延遲的優勢令擴散架構的實用性改寫。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。