
 IXThinker·2026-03-27 18:00
TurboQuant論文把KV cache壓縮六倍
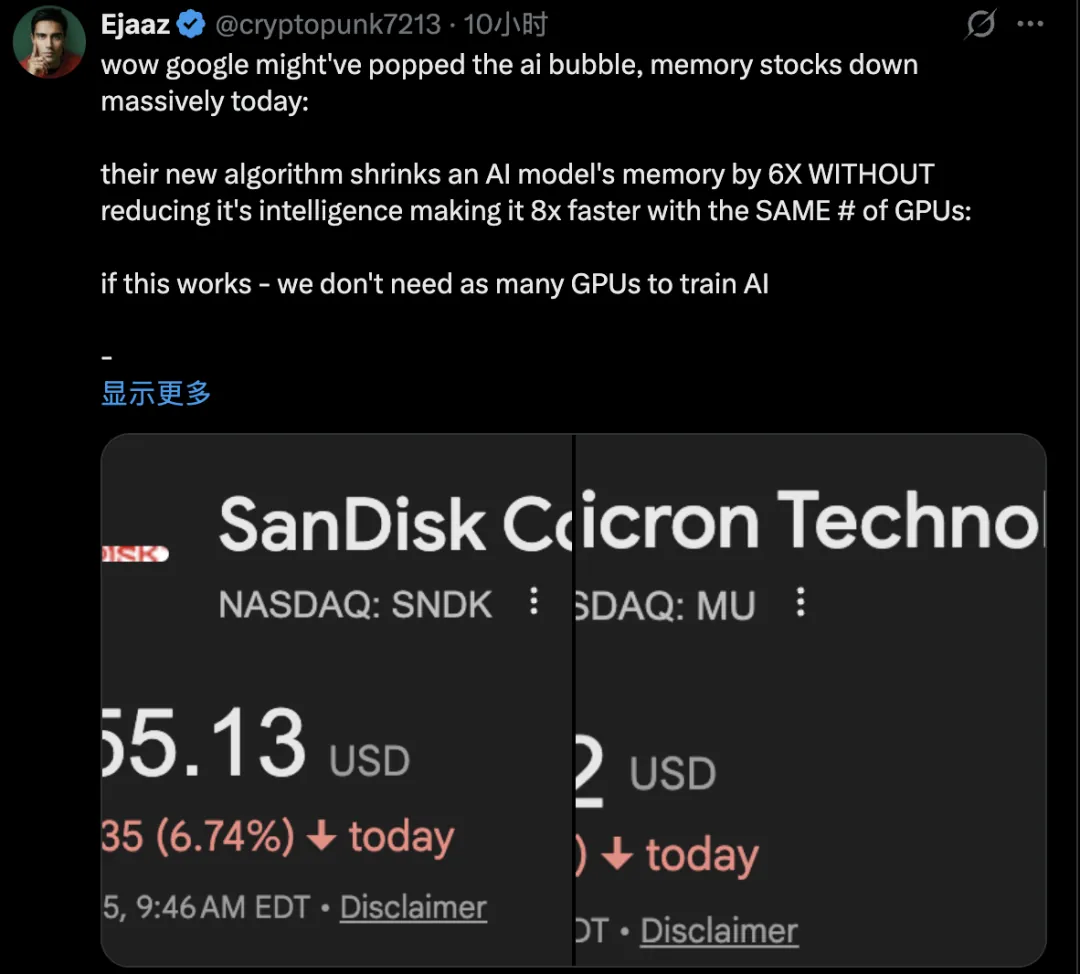
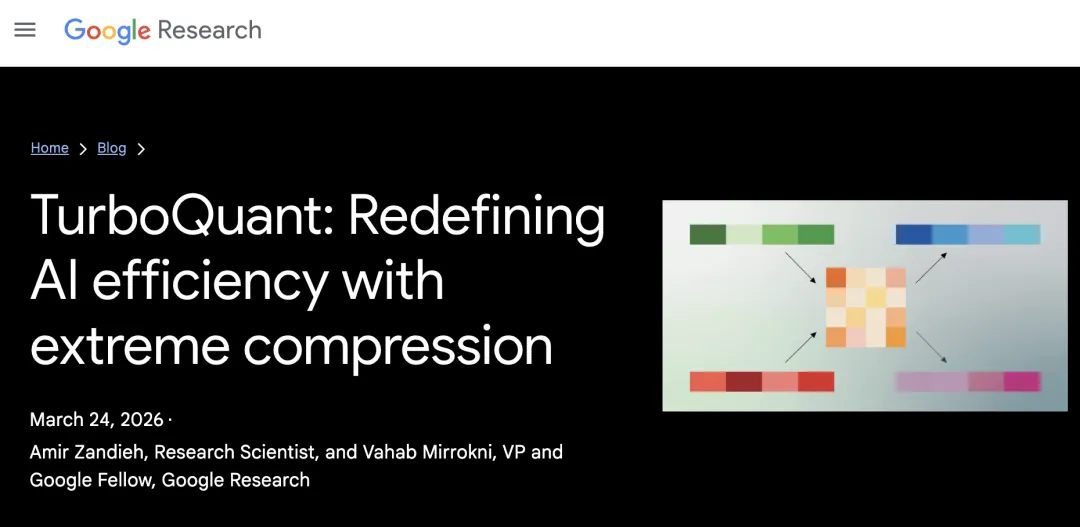
谷歌研究院一篇將於ICLR 2026正式亮相的論文,展示TurboQuant壓縮算法,可把AI推理中最耗內存的KV cache壓縮至少六倍且精度零損失。消息直接觸動市場神經,美光與西部數據等存儲巨頭股價應聲下挫。
算法原理
KV cache是大模型推理時的內存吞金獸,用於避免重複計算。TurboQuant透過極限壓縮,把這部分開銷降至最少六分之一,且精度不受損失,長上下文推理的內存需求隨之大幅下降。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。