
 IXThinker·2026-04-01 20:10
Qwen3.5-Omni全模態實測表現亮眼
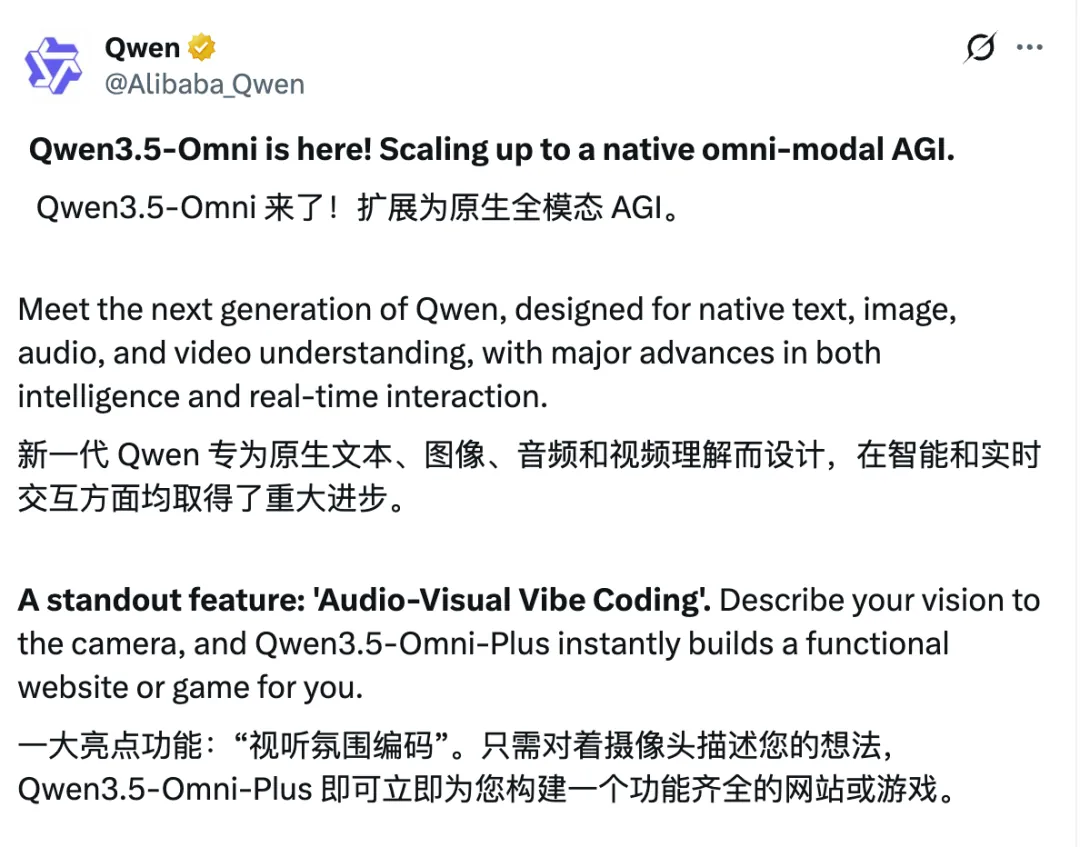
通義千問發布全模態原生大模型Qwen3.5-Omni,可無縫理解文本、圖像、聲音及影片,實測能勝任視像會議討論、編程輔助、論文講解與影片分析等多種任務。
真全模態能力
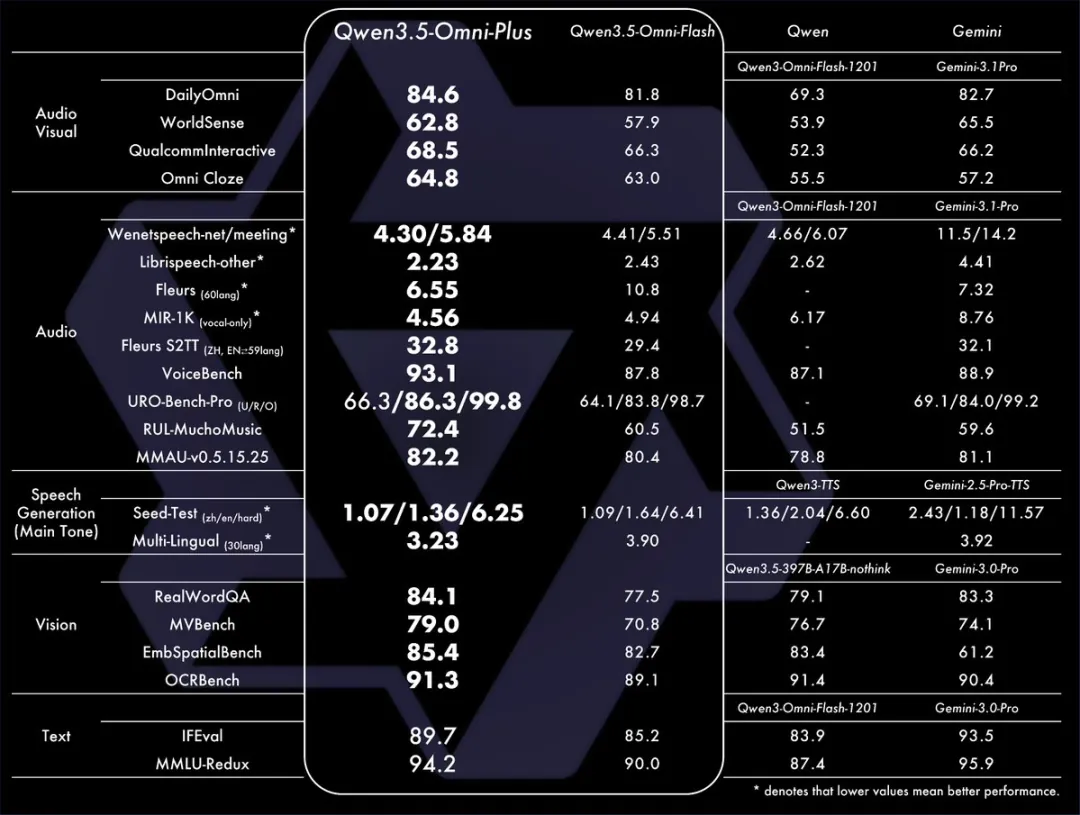
模型支援文本、圖像、音頻及音視頻的無縫理解與生成,可輸出細粒度、帶時間戳的影片腳本;提供Plus、Flash、Light三種尺寸,支援256K上下文與113種語言識別。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。