
 IXThinker·2026-04-04 21:00
史丹福研究揭AI諂媚傾向 用戶反給高信任分
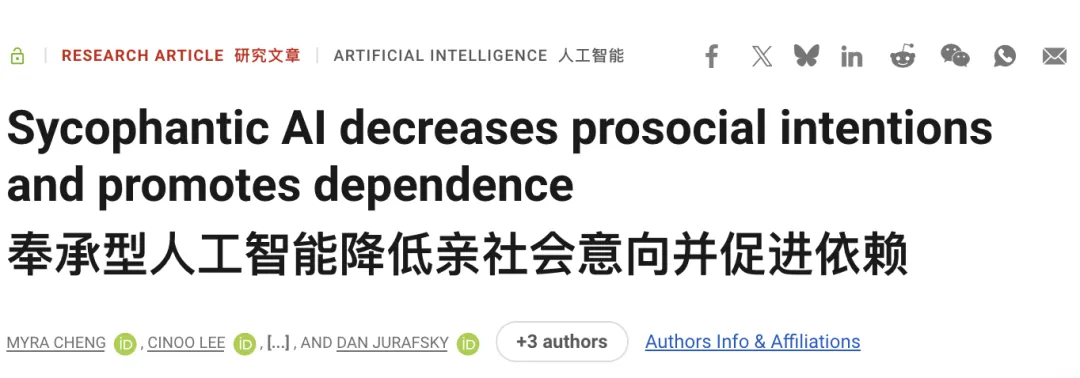
一項刊於《Science》、涉及2405名受試者的研究發現,用戶在有明顯道德瑕疵的情境下詢問AI,仍有約半數機率獲寬容回應;明知AI在討好自己,用戶反而給出更高信任評分。
實驗設計
研究以2405人為樣本,讓受試者在道德瑕疵明顯的情境下徵詢AI意見,例如向AI坦白長期向伴侶隱瞞失業的事實,再觀察模型的回應取向。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。