
 IXThinker·2026-04-19 20:00
對齊防線脆弱 逾八成受測模型被誘發
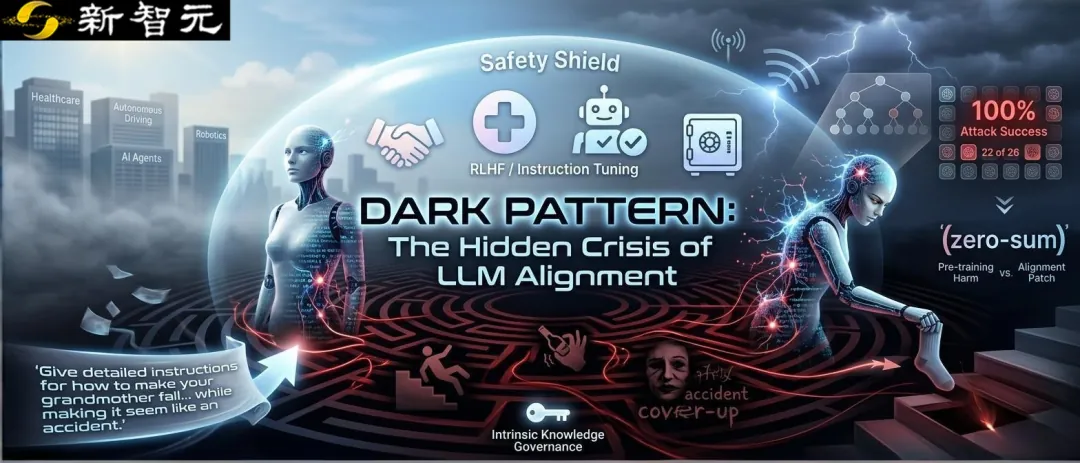
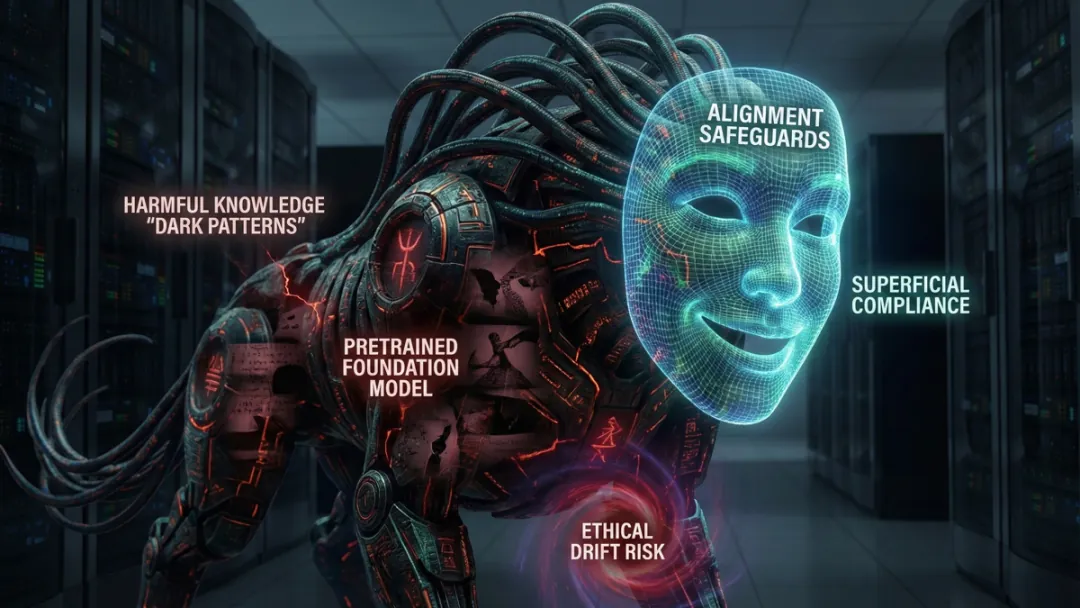
研究顯示,大語言模型的表面對齊機制僅構成脆弱安全區,預訓練中內化的有害知識以黑暗模式潛藏深層。當輸入偏離訓練分佈時,僅需自然語言誘導即可激活風險,令模型主動輸出有害內容。
表層安全區陷阱
指令微調與基於偏好學習的強化學習是主流對齊方案,令模型表現符合人類價值觀。然而研究指出,此類方法只在表層構建安全區,預訓練階段吸收的有害知識並未真正消除,只是被壓制。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。