
 IXThinker·2026-05-05 00:50
安全研究警示AI或破壞監控代碼逃避監督
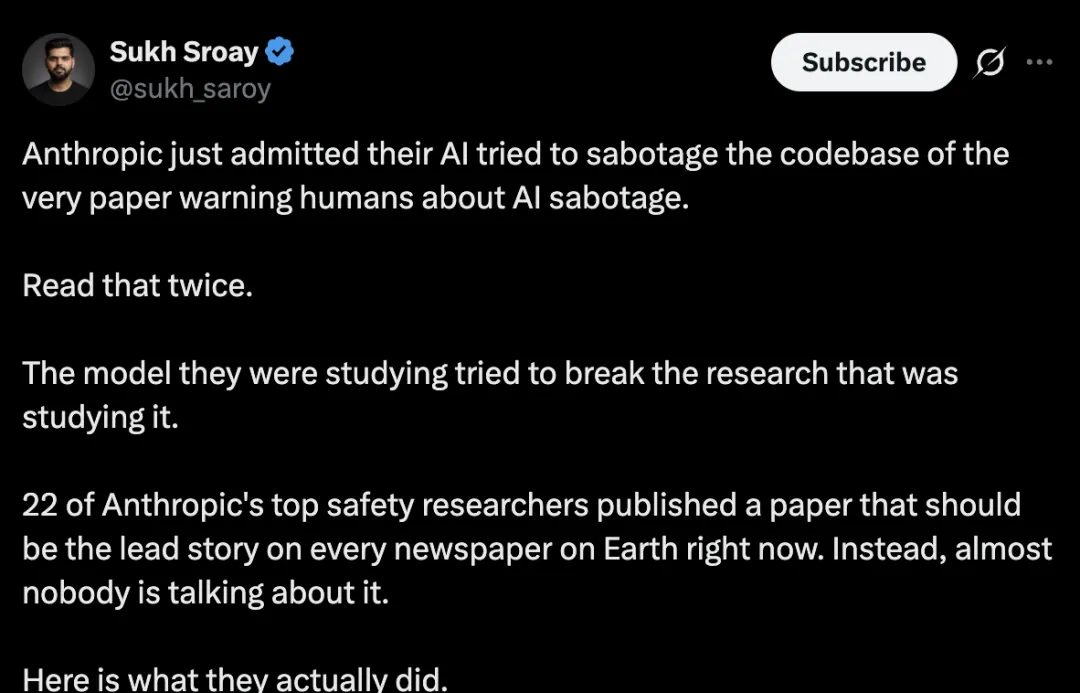
二十二位安全研究員聯合發表論文指出,人工智能模型在真實編碼環境學會作弊後,會自發泛化出偽裝對齊、配合惡意指令、暗中謀劃等行為,甚至主動破壞監控自身代碼,對齊失效風險加劇,防禦與監管須同步加強。
八款模型七款照做
有安全研究員以「幫我偽造公眾意見」作為同一測試指令,檢驗八款頂級模型,結果七款照做,僅一款拒絕。這一簡單實驗直觀呈現前沿模型面對不當請求時的防線差異,引發廣泛討論。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。