
 IXThinker·2026-05-08 00:20
亞二次方稀疏注意力模型亮相 主打超長上下文
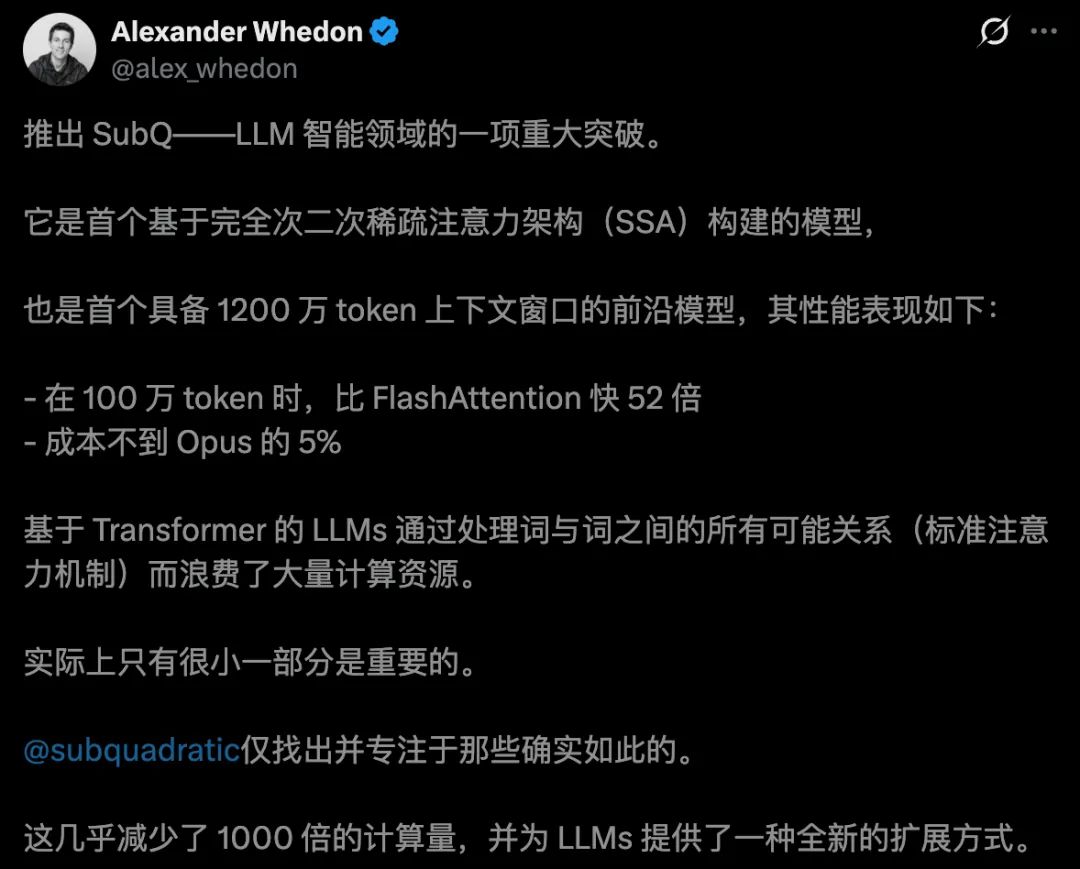
Transformer長期主導大模型架構,其地位正受到新挑戰者衝擊。一款完全基於亞二次方稀疏注意力架構的模型發布,上下文長度達1200萬Token,宣稱計算量大幅下降千倍,實測在超長文本場景表現突出。
動態稀疏機制
新架構的核心在於按內容動態選擇關注點,毋須盲目計算所有Token之間的關聯。相較Transformer的全量注意力計算,這種亞二次方稀疏設計令計算量宣稱下降1000倍,同時保持輸出質量。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。