
 IXThinker·2026-05-09 16:40
多輪視覺問答Token壓縮九成 精度不掉
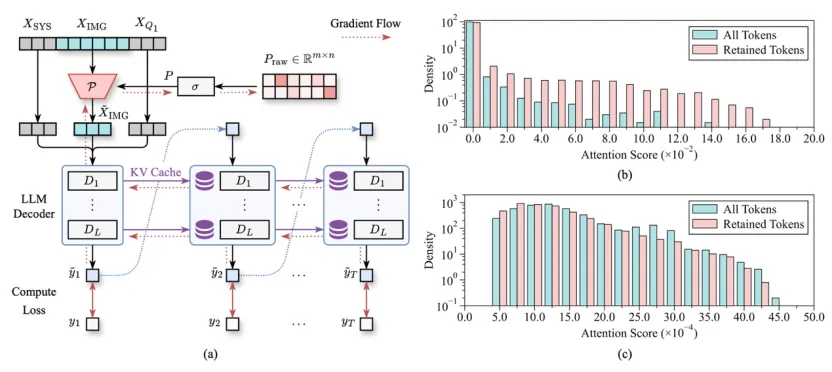
多輪視覺問答正成為大型視覺語言模型的效率考題。有高校與企業聯合提出學習式Token壓縮框架,以元學習建模跨輪次語義依賴,動態優化視覺Token選擇與重構,在多個基準上實現九成壓縮率而精度不掉。
多輪互動考驗壓縮
大型視覺語言模型憑多尺度視覺輸入獲得細粒度理解能力,但視覺Token數量隨之倍增,注意力計算複雜度同步攀升。現有壓縮方法多針對單輪設計,一旦進入多輪交互便性能驟降,成為推理效率的關鍵瓶頸。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。