
 IXThinker·2026-05-20 14:50
大模型自教自學強化學習系列研究
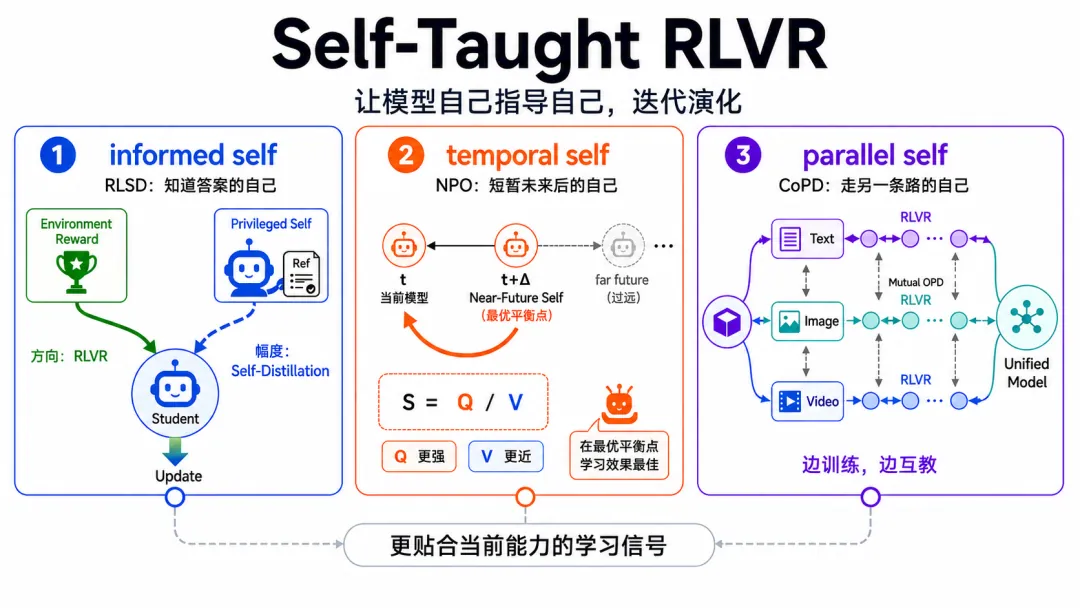
如何讓大模型自我指導、迭代演化?京東與中科院信工所連發三篇後訓練論文,圍繞Self-Taught RLVR展開,從三個互補維度探索擺脫人工標註與外部獎勵的自主進化路徑。
三篇論文三種自我
系列研究提出三個互補視角:RLSD利用特權信息增強的知情自我自教;NPO聚焦時序自我,以近未來的反饋教導當前策略;第三篇則探索走另一條路的平行自我。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。