
 IXThinker·2026-06-26 00:35
AI解釋輔助破解腦區功能偏好之謎
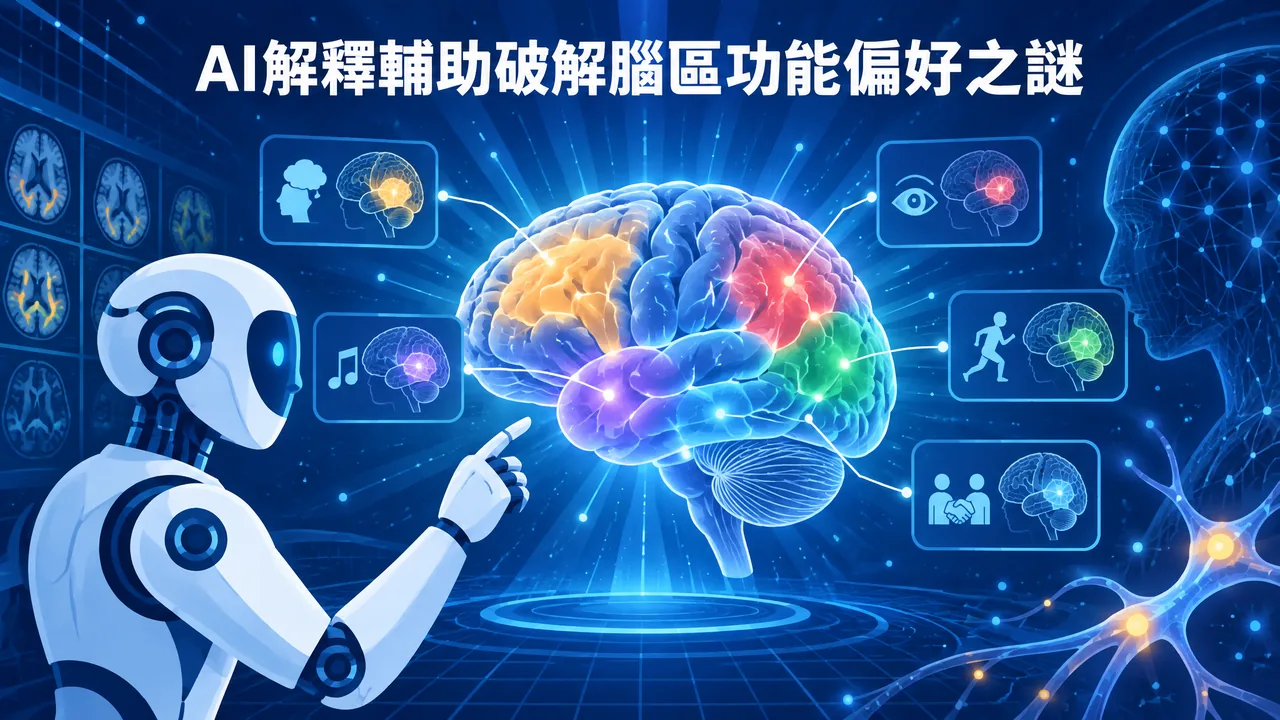
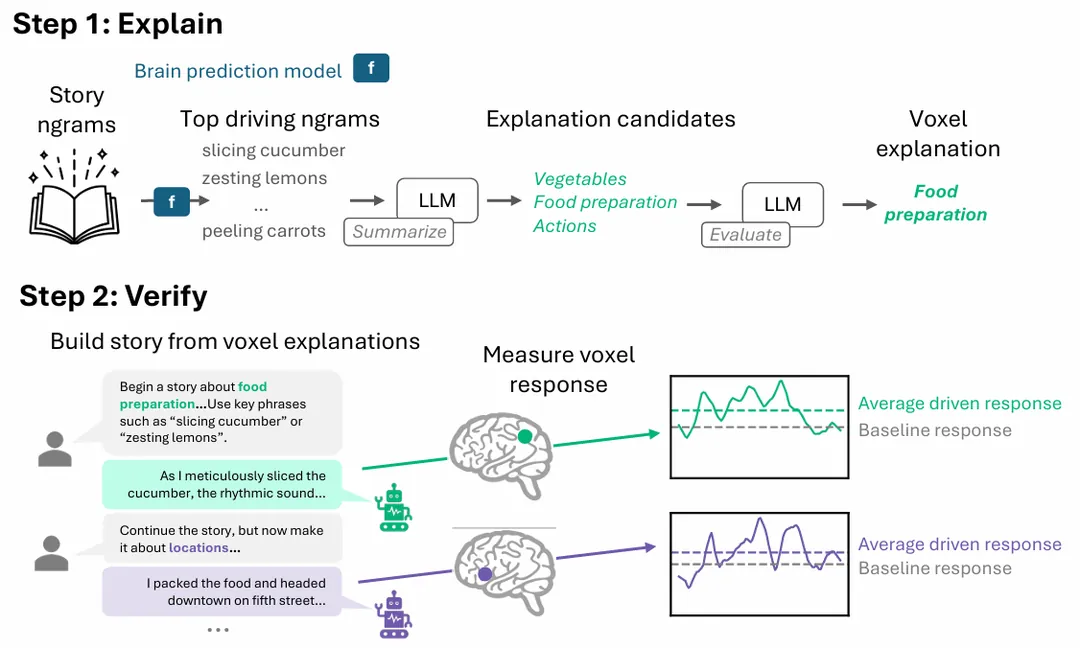
基於大語言模型的腦響應預測雖然準確,內部機制卻缺乏可解釋性。多機構合作提出生成式因果檢驗方法,將黑箱模型提煉為可讀的自然語言描述,再透過功能性磁振造影因果驗證,成功復現已知腦區功能選擇性。
黑箱之困
語言模型可以準確預測大腦對外界刺激的響應,但研究人員難以知曉模型究竟學到什麼,缺乏可解釋性令神經科學發現難以沉澱,也限制了解碼技術在臨床與科研中的可信度。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。