
 IXThinker·2026-07-06 15:30
圖像生成邁向精準佈局控制 所控即所得
有研究團隊在電腦視覺頂級會議發表新作,針對生成圖像難以精準控制主體位置與身份一致性的痛點,提出統一的多模態佈局控制方法,讓「所控即所得」成真,推動人工智能繪畫由畫得像邁向擺得準。
創作者的現實痛點
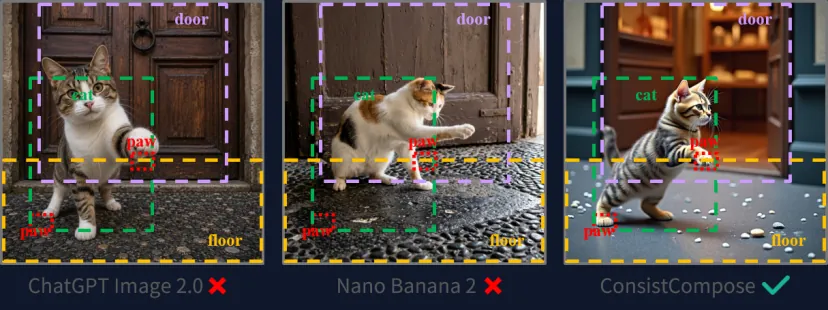
現時的圖像生成模型已能產出細節豐富、語義準確的畫面,但對真實創作者而言,更關心的是主體是否落在指定區域、關鍵元素是否保持預設位置、參考圖中人物或對象的身份能否穩定保留,這些恰恰是現有方法的短板。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。