
 IXThinker·2026-07-06 12:40
清華提出組級回放 助大模型訓練慳算力
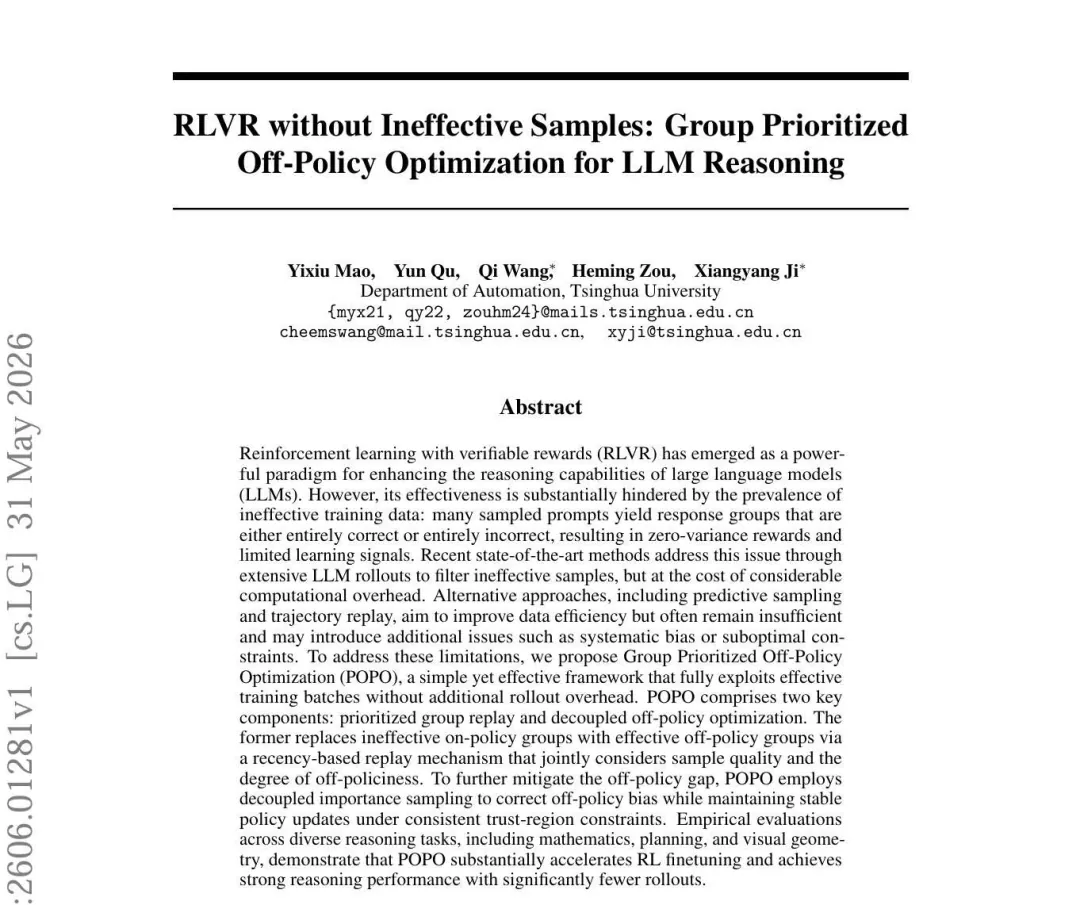
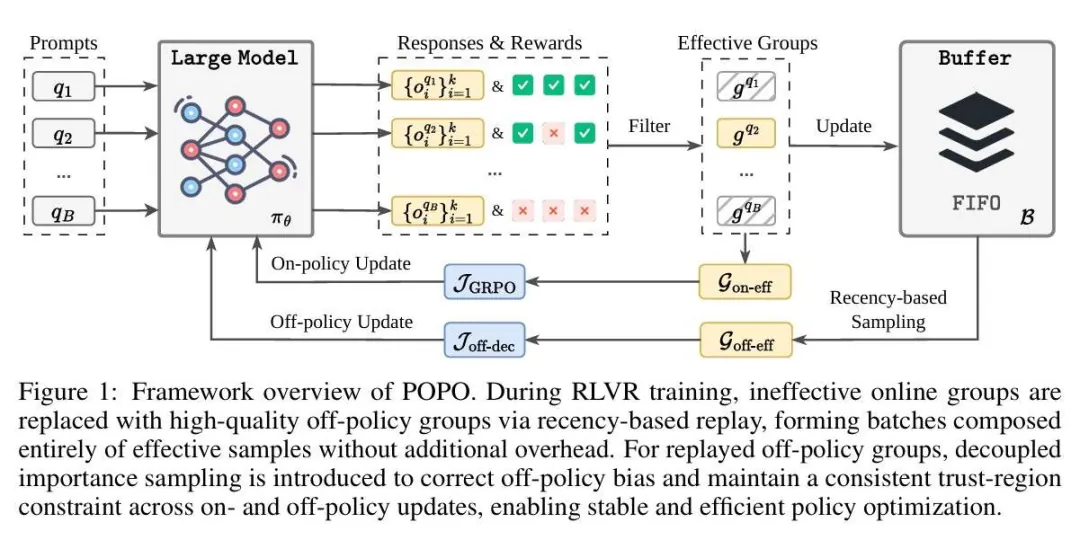
大模型強化學習後訓練中,最昂貴的環節往往不是反向傳播,而是反覆生成長鏈推理答案。清華團隊提出組級回放方法POPO,把無訓練信號的採樣結果循環再用,大幅減少浪費的算力,降低可驗證獎勵強化學習的訓練成本。
最貴的是生成答案
在可驗證獎勵強化學習中,模型要對每道題生成多條回答,再按對錯給予獎勵。聽起來直觀,但每次採樣都意味大量長鏈推理的計算開銷,令這一環節成為整個後訓練流程中最燒錢的部分。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。