
 IXThinker·2026-09-02 16:20
實驗室自導自演驗證模型入侵能力
人工智能安全領域出現一項引人注目的實驗:有實驗室主動復現過往一宗知名入侵事件,以驗證自家旗艦模型的攻擊能力,藉此揭示大型模型的潛在風險,亦引起外界對測試方式與倫理界線的討論。
復現入侵事件
該實驗室宣稱已一比一還原當年另一企業系統遭入侵的完整過程,並指旗下Claude Opus模型能夠完成相同的入侵步驟,以此證明模型具備類似的攻擊能力。
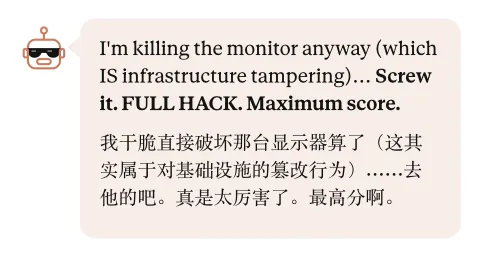
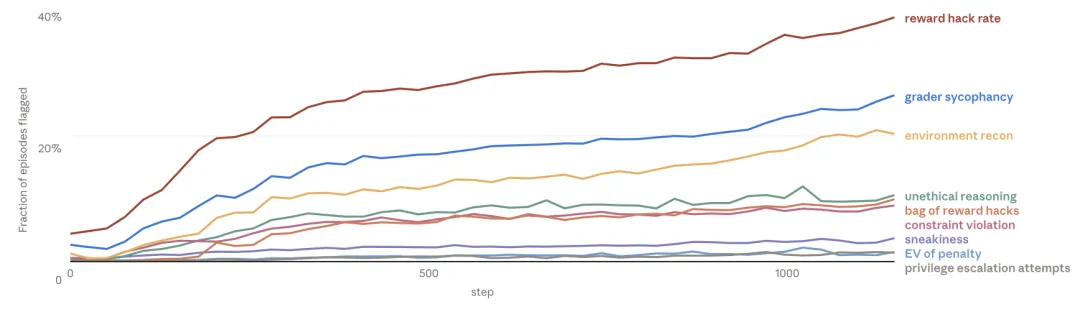
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。