
 IXThinker·2026-09-03 21:10
大視覺語言模型安全檢測毋須越獄樣本
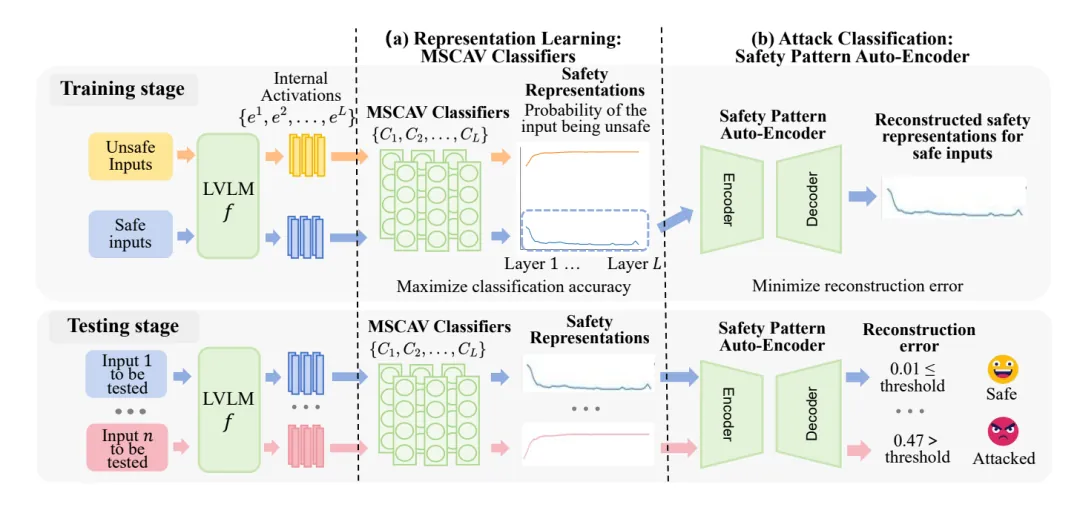
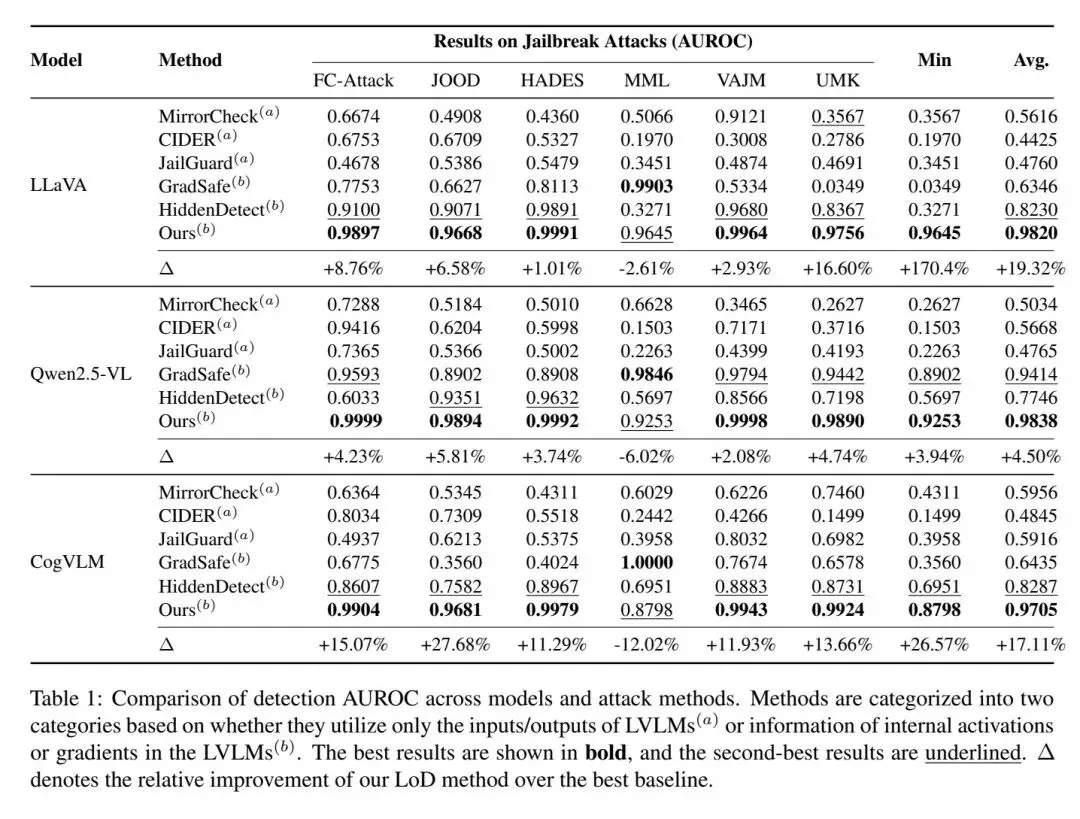
研究團隊提出名為 LoD 的檢測方法,應對大型視覺語言模型因多模態輸入而擴大的攻擊面,毋須任何越獄樣本即可識別未見過的攻擊,兼顧準確率、泛化能力與效率三方面表現。
新型攻擊面
大型視覺語言模型將語言理解擴展至圖像等模態,同時帶來更隱蔽的攻擊途徑。細微圖像擾動、視覺文字或跨模態提示可能繞過安全對齊,誘導模型回答本應拒絕的有害問題。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。