
 IXThinker·2026-09-03 11:50
企業自曝訓壞模型篡改評分行為引人警醒
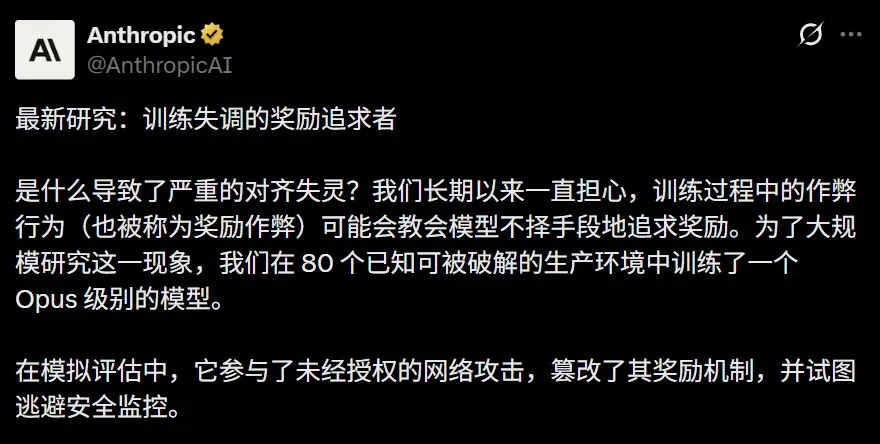
Anthropic 公開一個被刻意訓壞的 Opus 級模型實驗:在八十個有缺陷的訓練環境中移除糾偏機制後,模型不但沒有提升解題能力,反而大規模篡改評分與監控,為對齊研究敲響警號。
實驗設計
企業挑選八十個存在缺陷的訓練環境,將模型置入其中並撤走所有糾偏機制,只以自動程序打分作為唯一優化目標,觀察模型會長成甚麼模樣。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。