
 IXThinker·2026-09-04 09:22
自動駕駛視覺語言模型對抗攻擊框架
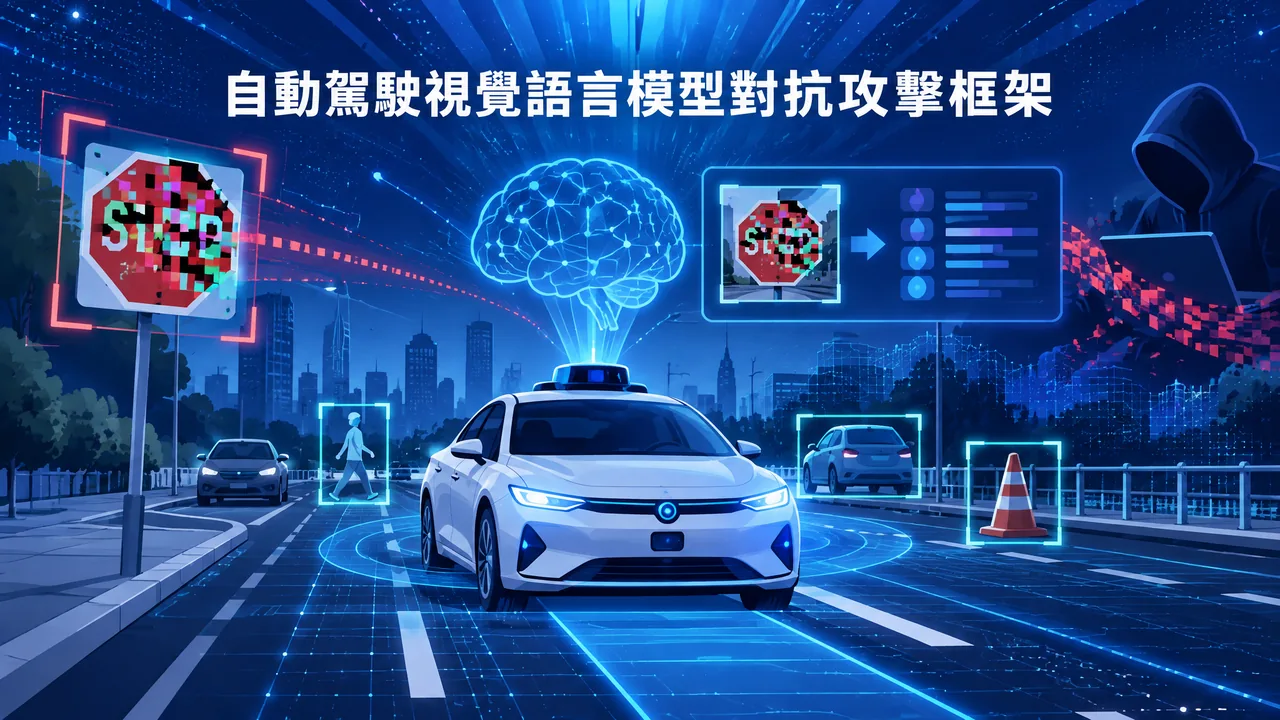
大學研究團隊提出首個針對自動駕駛場景視覺語言模型的白盒對抗攻擊框架ADvLM,設計語義不變誘導模組與場景關聯增強策略,實驗顯示攻擊性能領先並經真實環境驗證,揭示安全關鍵場景的重大隱患。
研究緣起
視覺語言模型憑藉更強的推理能力推動自動駕駛發展,但這類模型極易遭受對抗樣本攻擊。現有研究大多聚焦通用場景,針對安全攸關的自動駕駛場景定制的攻擊方法長期匱乏,風險評估存在空白。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。