
 IXThinker·2026-09-22 17:00
復旦推出影音評審模型對齊人類審美
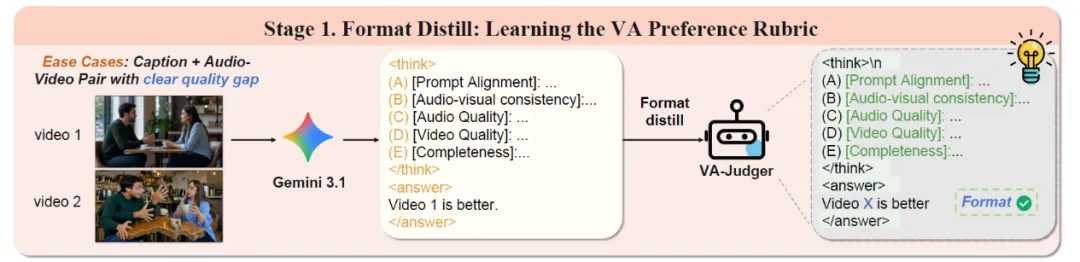
現有影音獎勵模型能評局部指標,卻忽略聲音失真、台詞與提示不符等整體問題,且在強化學習中易被刷分而不實質提升質量。有大學團隊提出新評審模型,從人類對完整影音結果的偏好中學習,助提升影音生成水平。
現有裁判的盲點
現有影音獎勵模型能捕捉畫質或同步性上的優勢,卻往往忽略聲音失真、台詞與提示不符、動作與語音配合不自然等問題。畫面、聲音、文本匹配各自評分,加總卻未必等於人的整體感受。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。