
 IXThinker·2026-09-25 17:20
文字生成音訊影片提效五十四倍
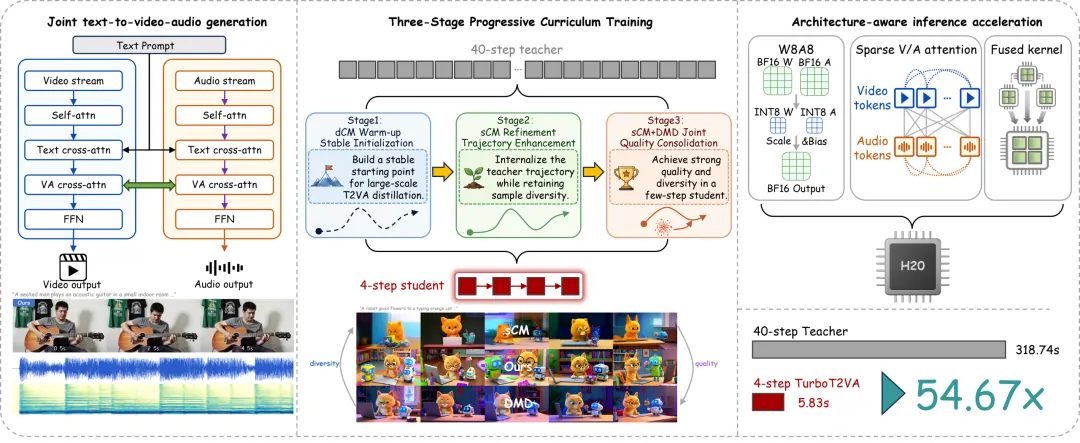
文字到音訊與影片的聯合生成,成本來自兩個方向:長採樣軌跡要求反覆執行前向計算,高分辨率音訊影片Token又讓每一步都很重。多校團隊提出TurboT2VA,把生成提速五十四倍。
兩層成本難題
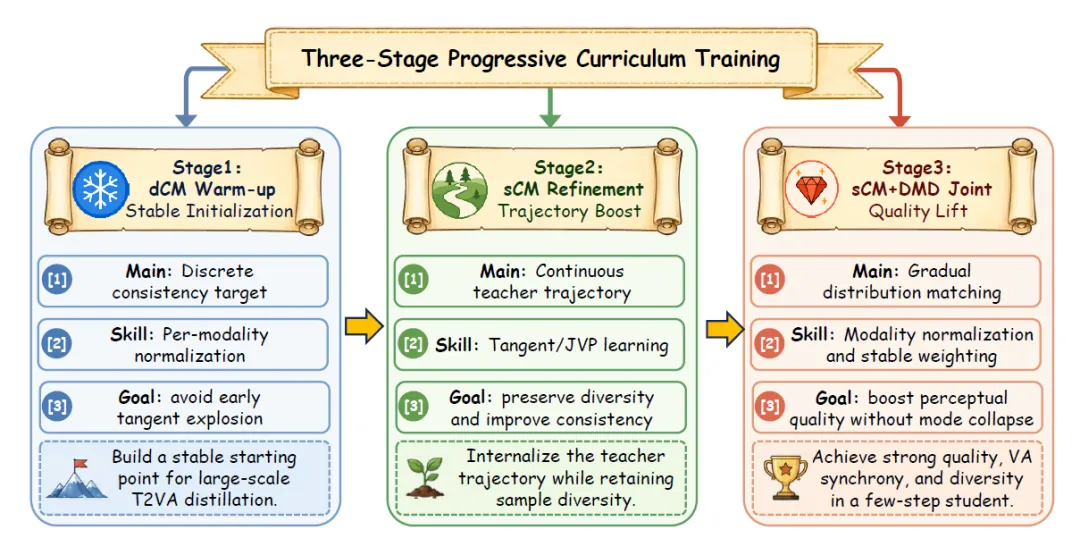
只減少採樣步數,單步計算仍然昂貴;只優化算子,多步採樣的重複計算依然存在。來自浙江大學、清華大學、新加坡國立大學等的研究團隊,決定從兩個層面同時下手。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。