
 IXThinker·2026-10-13 13:10
新研究提出推理時偏好對齊直接修正內部計算
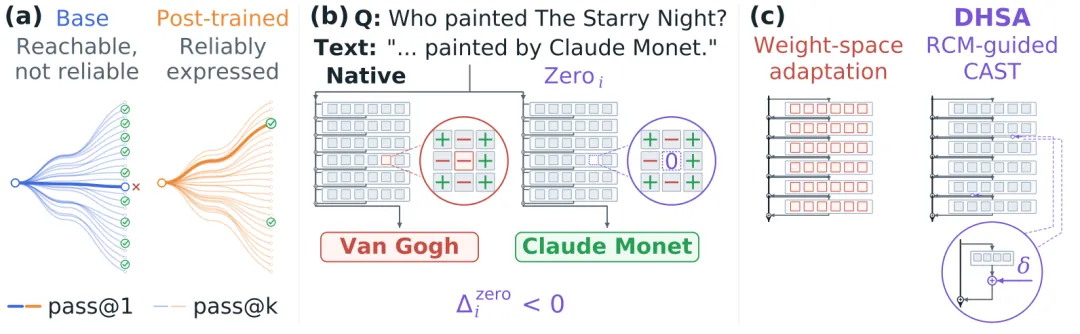
來自成都大學、復旦大學等多所高校的研究團隊提出直接隱狀態對齊方法DHSA,在推理時直接修正模型內部計算路徑。僅用256至16384個控制參數即可達到DPO水準,為不依賴外部反饋的對齊提供了新範式。
對齊研究的再聚焦
讓大模型穩定地按照人類期望行動,是偏好對齊的核心目標。RLHF、DPO等主流方法依賴反饋信號優化模型,而這項研究選擇另一條路:探究已有對齊行為為何難以穩定表達,能否直接在內部予以糾正。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。