IXThinker·2026-10-26 00:40
AI框架由序列推算殘基酸解離常數獲驗證
蛋白質中可電離氨基酸殘基的質子化狀態,影響其結構穩定性、催化活性及生物功能,惟酸解離常數的準確預測一直是計算生物學難題。研究人員提出基於蛋白質語言模型的框架KaML-ESMs,直接由序列推算相關數值。
傳統方法面對限制
過往預測酸解離常數的方法,主要依賴蛋白質三維結構配合物理化學計算,普遍存在計算成本偏高、預測精度有限,以及難以應用於大規模數據等問題。
氨基酸殘基的質子化狀態同時牽涉蛋白質的結構穩定性、催化活性及生物學功能,若預測不準,會影響後續的功能分析與蛋白設計工作,因此準確推算相關常數備受重視。
框架設計與訓練策略
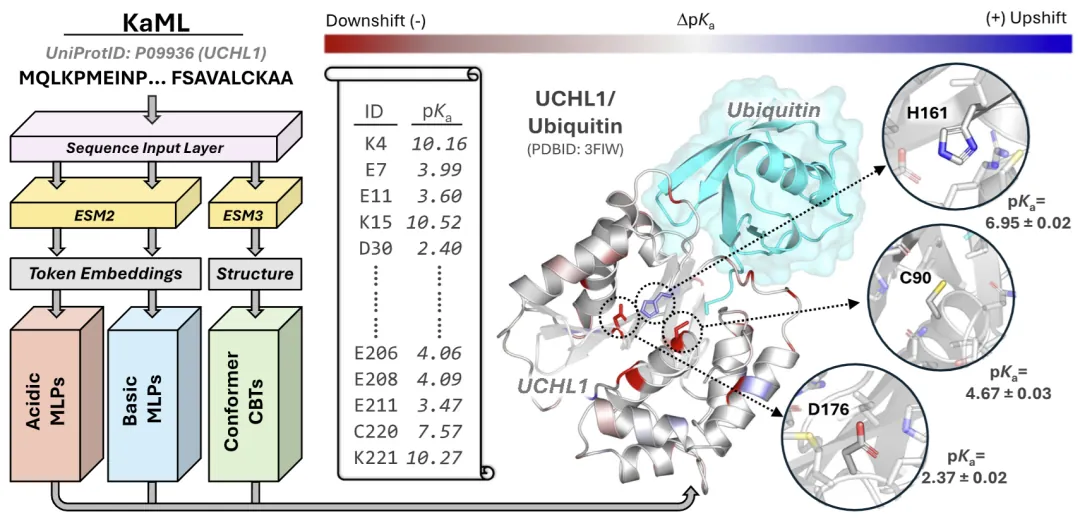
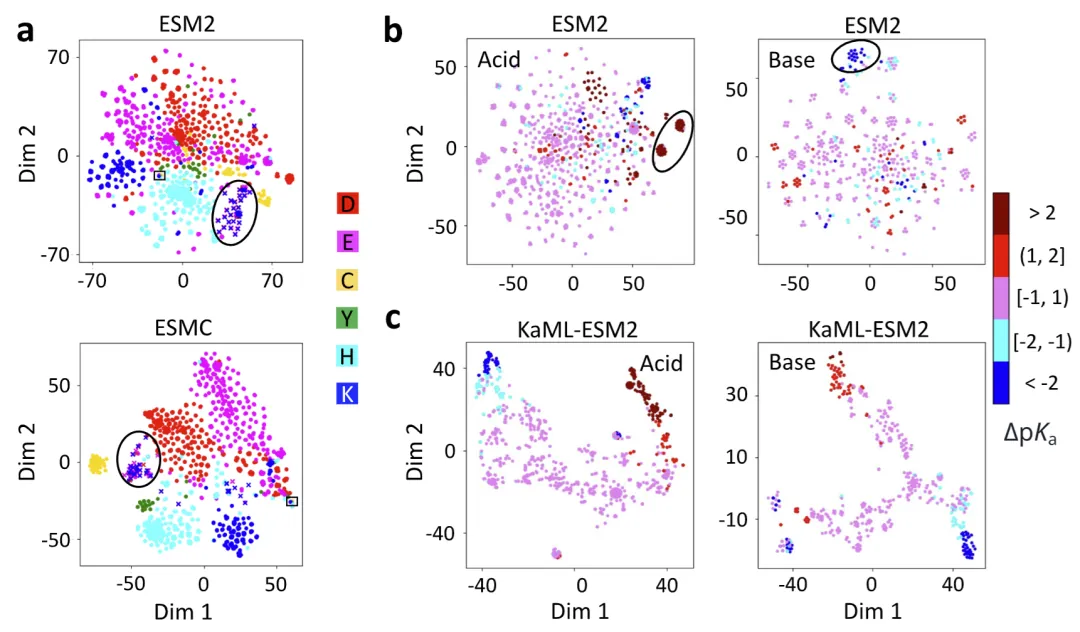
新框架名為KaML-ESMs,分別利用蛋白質語言模型ESM2與ESMC提取殘基級表徵,再結合實驗取得的酸解離常數數據進行訓練,使模型能直接從蛋白質序列得出預測結果。
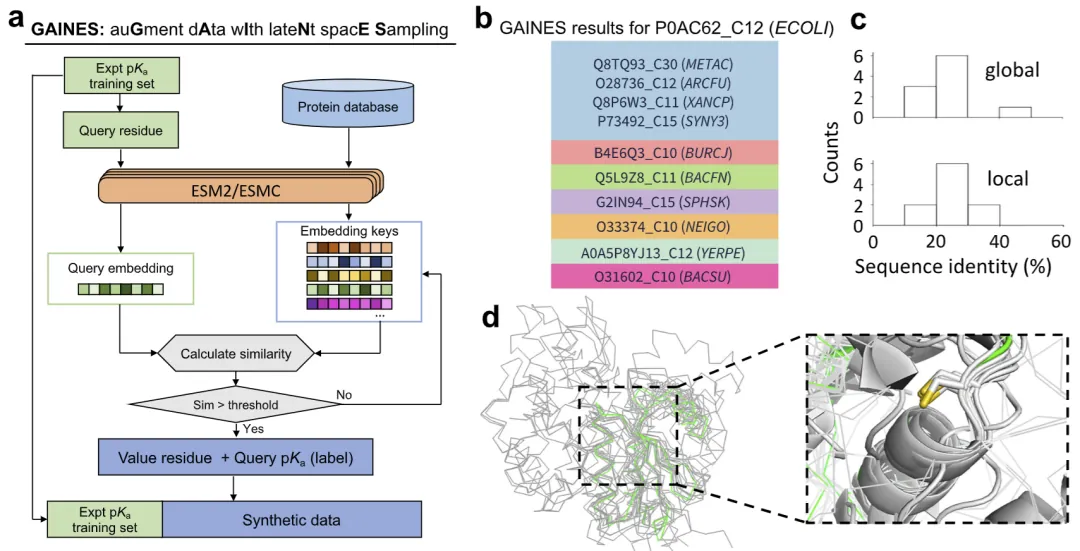
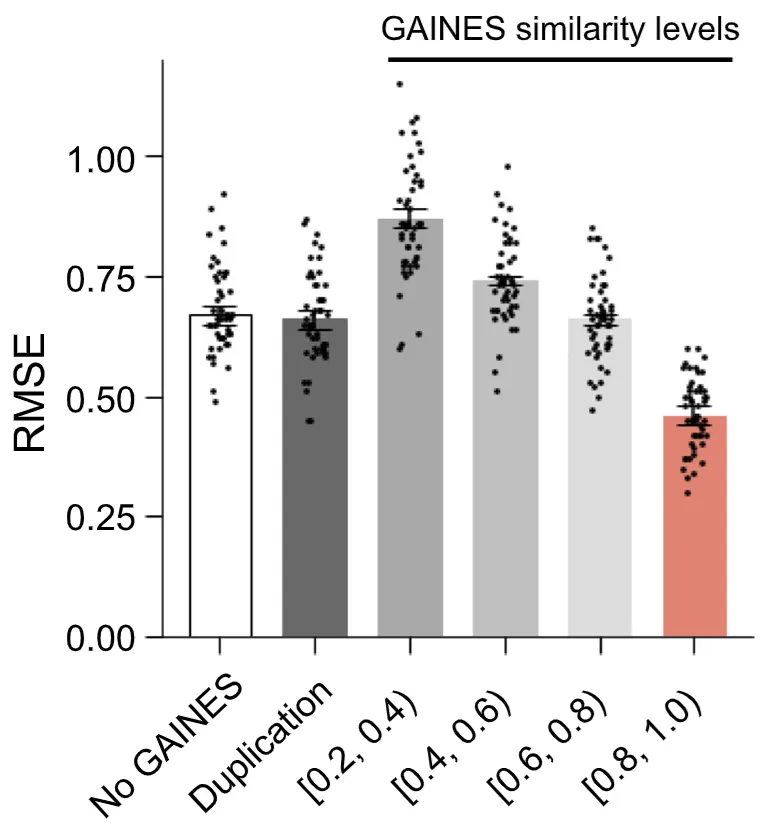
研究團隊同時提出名為GAINES的潛在空間採樣增強策略,透過在潛在空間中採樣擴充訓練樣本的覆蓋範圍,協助模型學習更多殘基所處的化學環境,從而改善預測表現。
適用殘基與測試結果
該方法可直接預測天冬氨酸、谷氨酸、組氨酸、半胱氨酸、酪氨酸及賴氨酸六類殘基的酸解離常數值,覆蓋蛋白質中主要的可電離殘基類型,為靜電性質研究提供序列層面的推算途徑。
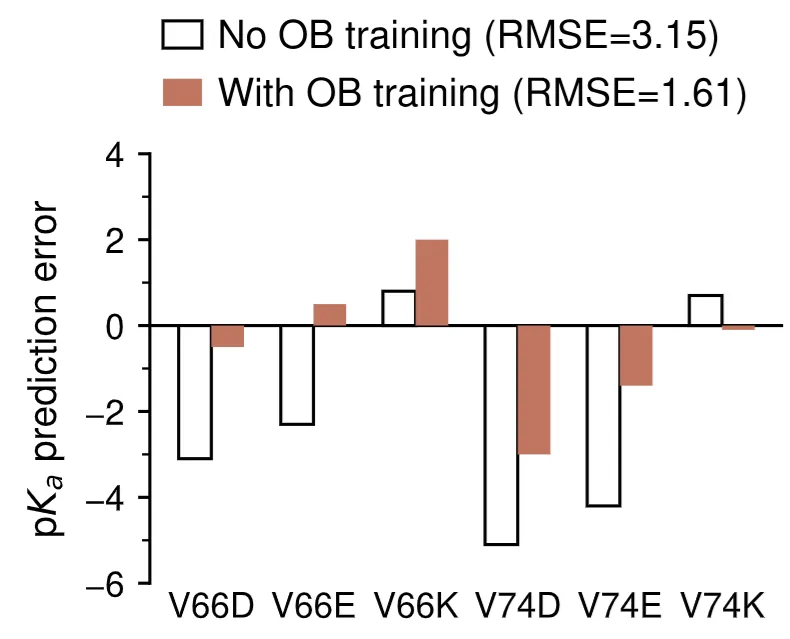
相關研究發表於《Nature Communications》。在四類基準測試中,基於ESM2與ESMC的兩個版本均展現預測能力;研究人員指,該框架實現高效且高精度的預測,提升大規模應用場景下的實用性與泛化能力。