IXThinker·2026-10-26 00:30
新數據庫縮窄蛋白序列與酶功能認知鴻溝
蛋白質序列數量隨測序技術發展持續上升,但經實驗確定功能的酶仍然有限,序列與功能認知的差距日益擴大。美國伊利諾伊大學厄巴納-香檳分校趙惠民教授團隊構建CLEAN DB,為逾5500萬條序列提供酶功能預測註釋。
序列與功能的鴻溝
準確註釋酶功能,是理解生命過程、發掘新型生物催化劑以及進行酶理性設計的重要基礎;惟測序技術快速發展,令蛋白質序列持續增加,實驗確認的功能資訊卻明顯滯後。
面對功能驗證速度遠遠落後於序列增長的現實,研究團隊在先前開發的人工智能酶功能預測模型CLEAN基礎上,進一步構建規模化的酶功能數據庫,把預測能力轉化為可直接查詢的資源。
數據庫覆蓋範圍
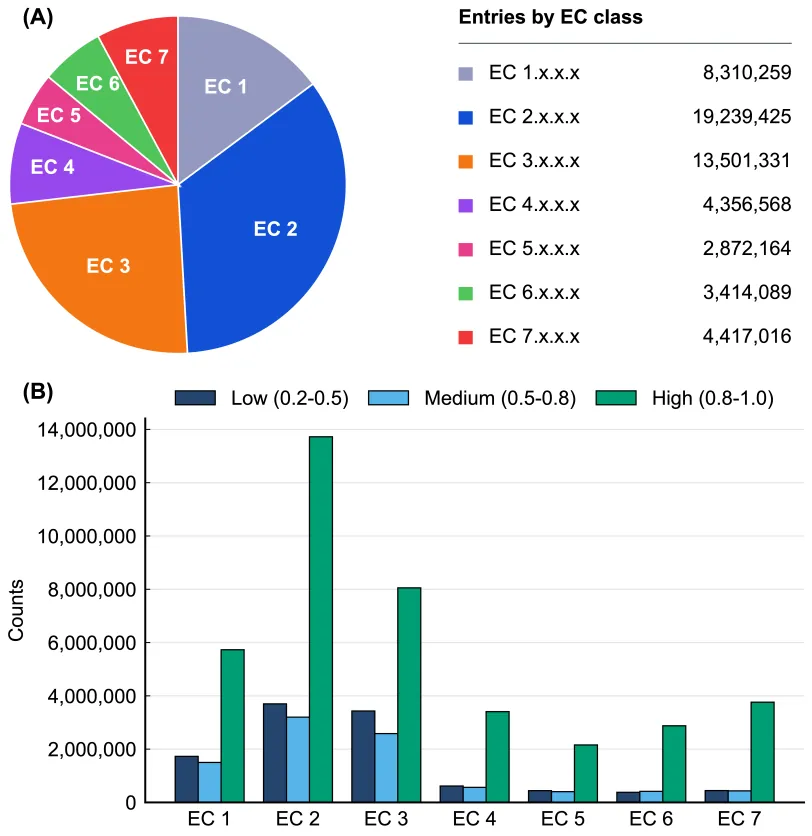
有關數據庫名為CLEAN Database(CLEAN DB),為超過5500萬條蛋白質序列提供酶功能預測註釋;研究論文發表於《Nucleic Acids Research》,由伊利諾伊大學厄巴納-香檳分校趙惠民教授團隊完成。
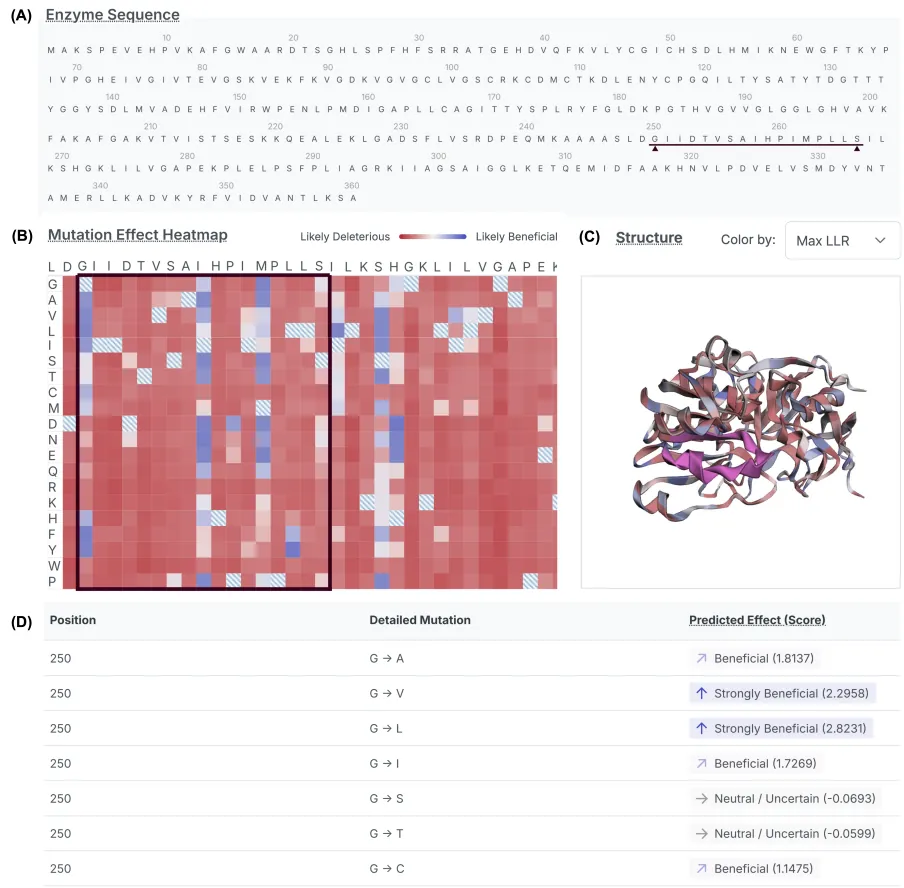
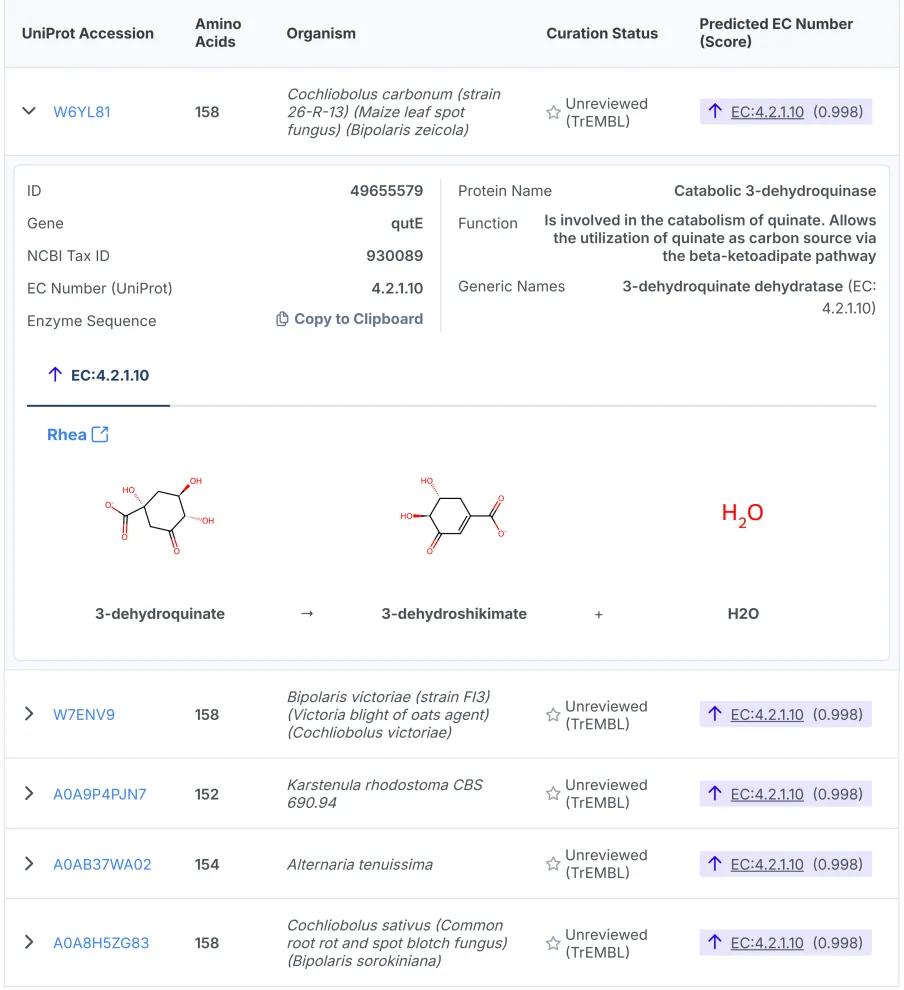
數據庫提供高精度且可解釋的酶功能預測,支援EC編號、GO術語及反應式等多維資訊,方便研究人員按不同需要查詢酶的催化功能及相關反應。
對研究的實際用途
藉助該數據庫,研究人員可以大規模檢視未經實驗驗證的序列,為新型生物催化劑的發掘及酶的理性設計提供參考,減低逐一實驗驗證所需的時間成本。
整體而言,有關資源旨在提升酶學研究的效率與可及性,令更多蛋白質序列對應的功能資訊可被查閱,從而逐步收窄序列數據與功能認知之間的長期差距。