IXThinker·2026-10-28 18:30
Meta新方法讓Agent糾錯經驗跨會話復用
智能體在一個任務中改正的錯誤,換到另一個會話仍可能重犯。Meta FAIR與普林斯頓大學團隊提出Self-Direction方法,把糾錯經驗保存為獨立適配器,供後續相似任務調用。
問題背景
智能體在一個任務中改正了某個錯誤,換到另一個會話卻可能重複犯錯。現行做法各有局限:把糾錯經驗寫入上下文或技能文件,之後仍需檢索並佔用上下文空間;通過微調把經驗寫入模型,則要承擔額外訓練成本,並處理新舊能力之間的干擾。
適配器保存經驗
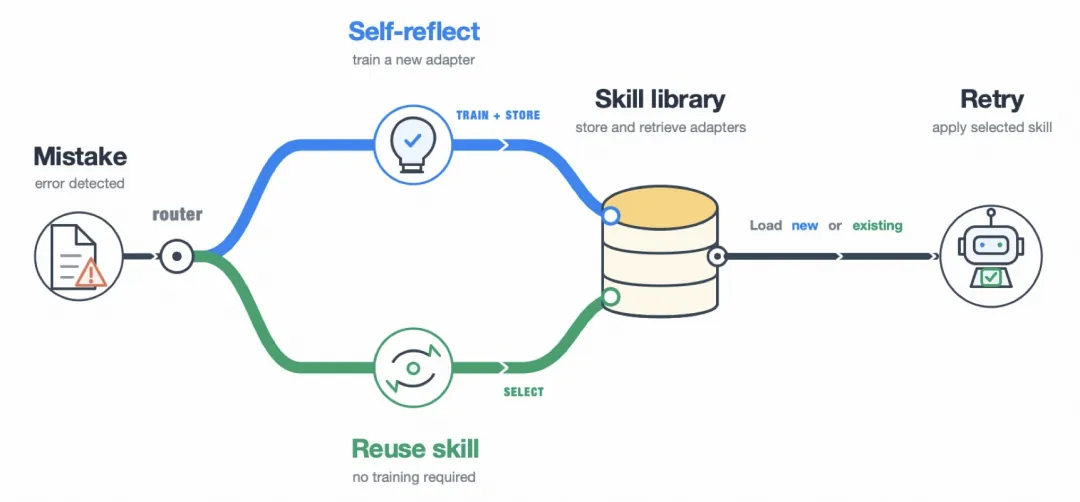
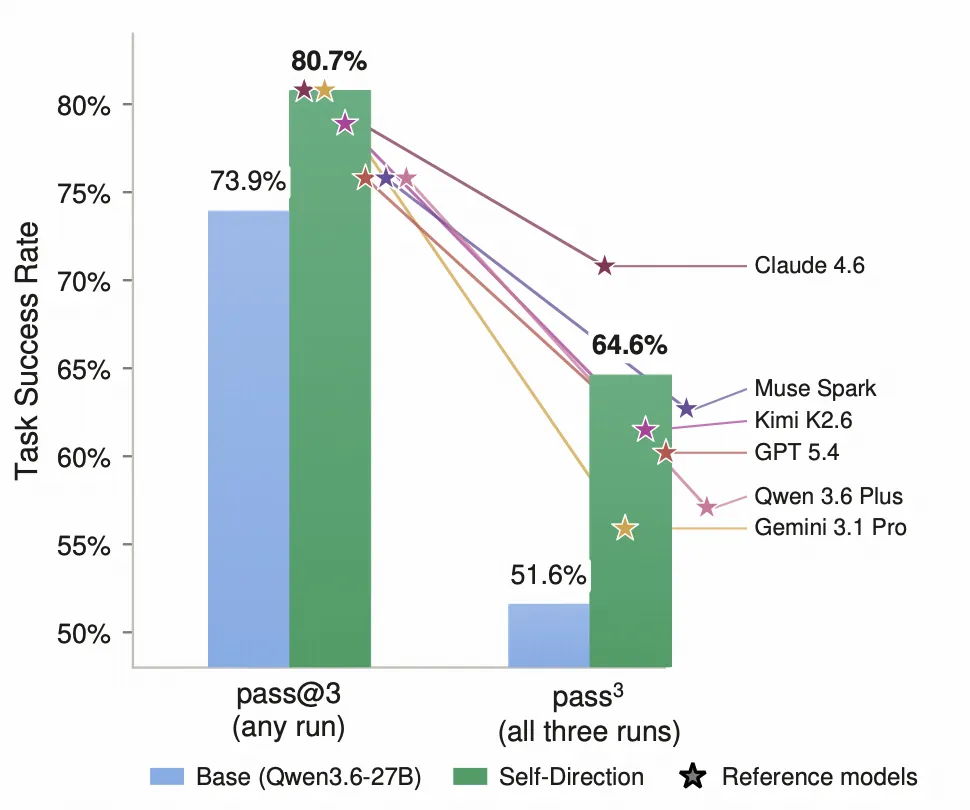
Self-Direction採用低秩適配(LoRA)技術,把智能體從錯誤中學到的經驗保存為獨立適配器。一次任務中完成的修正,可在後續相似任務中繼續使用,從而減少反覆糾正同類錯誤的開銷。
跨會話復用
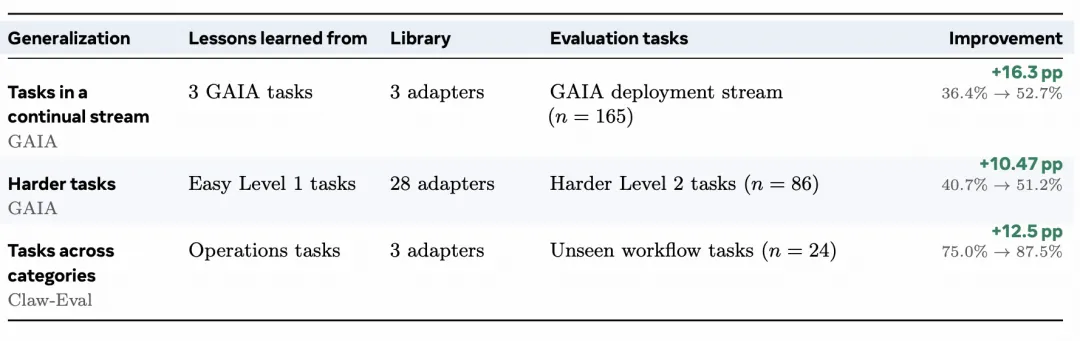
該機制令修正能力可跨會話復用,智能體遇到相似任務時自動調用相應適配器,避免重複犯錯。這種方式既節省上下文空間,亦無需對模型進行額外微調訓練,也降低了新舊能力互相干擾的風險。
持續學習方向
相關論文已公開發布。該方法為智能體記憶管理提供了區別於上下文記憶與模型微調的另一條路徑,團隊認為有助提升智能體的持續學習與泛化能力,為智能體長期運行中的經驗累積提供支撐。