IXThinker·2026-10-28 16:30
百度開源文心 OCR 2 連續轉寫整套小說
百度正式發佈並開源文心 Unlimited OCR 2,聚焦長文檔識別場景。模型通過將 KV 快取壓縮至常數規模,令單次處理頁數不再受限,官方並展示連續轉寫整套小說的能力。
整套小說連續轉寫
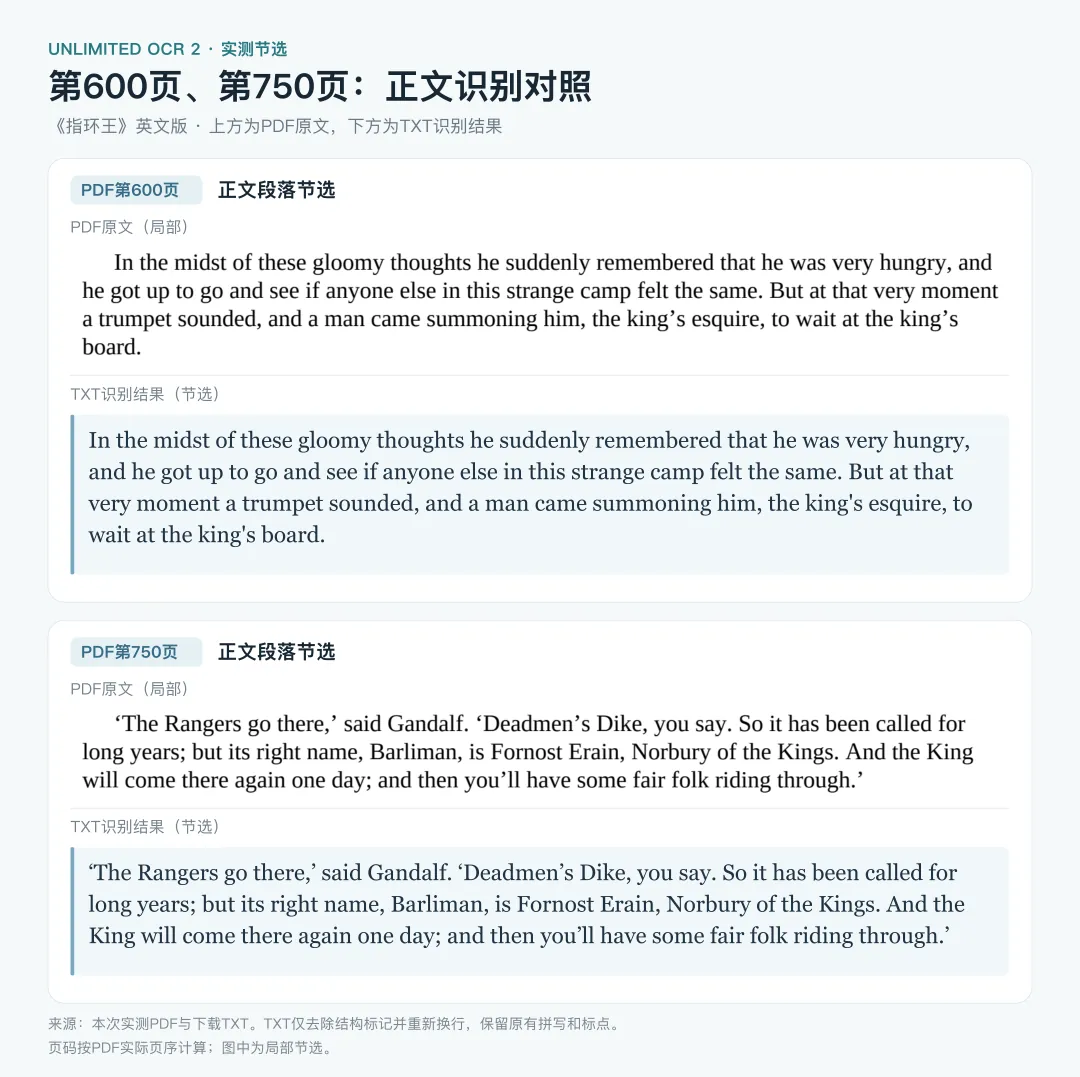
按官方發佈內容,文心 Unlimited OCR 2 可連續處理整套小說:7 部《哈利·波特》合共逾 3600 頁,自首冊讀至末冊,全程連續識別與轉寫;《三體》全集三冊逾 1200 頁、數十萬字,同樣全程無需中斷。
此類端到端無中斷轉寫,過去受制於長上下文 OCR 的瓶頸:文檔愈長,模型推理時需保留的中間資訊愈多,處理整本書乃至整套書時,往往需要先行分段再作拼接。
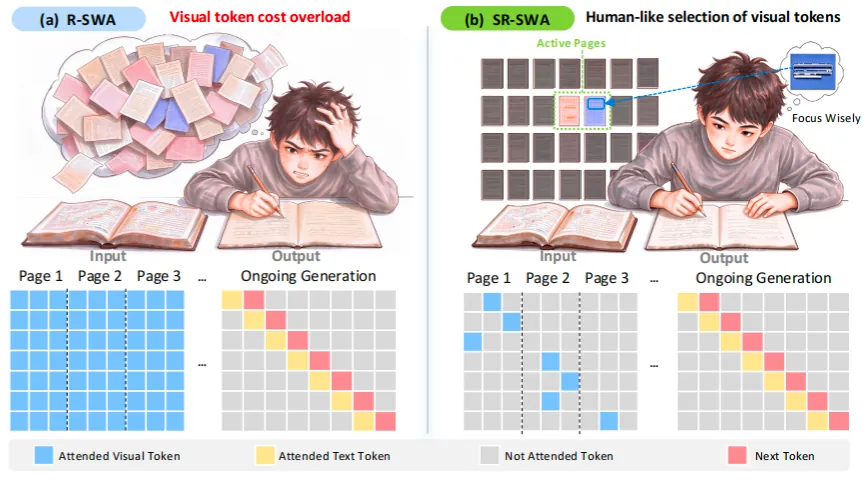
KV 快取壓縮至常數
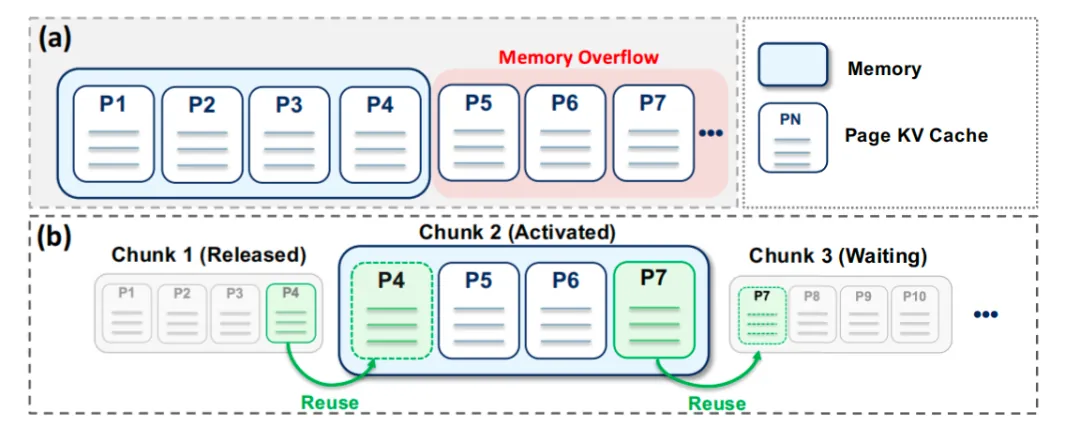
長文檔識別的核心難點在於快取負擔。KV 快取是模型推理時邊讀邊記的中間狀態,頁數愈多、快取愈大,既佔用顯示記憶體,亦拖慢讀取速度。
文心 Unlimited OCR 2 將 KV 快取壓縮至常數規模,令其大小不再隨文檔長度增長;官方在百頁級單序列測試中列出對比數據,快取用量減少約 96%,處理頁數由此不設上限。
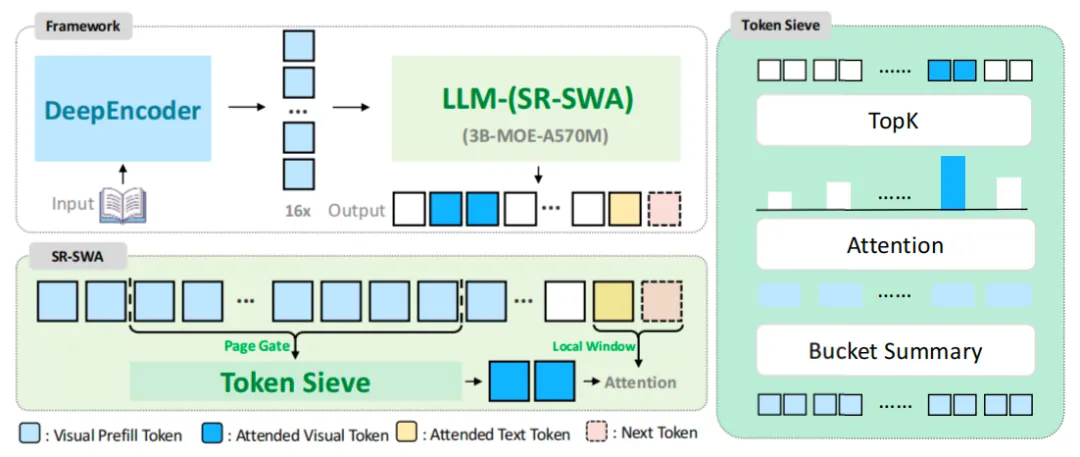
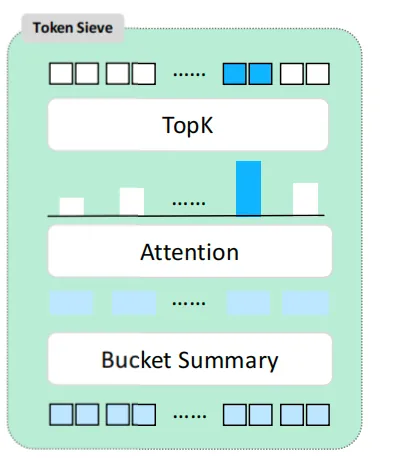
發佈與開源安排
該模型由百度正式發佈,並同步開源,供開發者與研究社群取用。官方將其定位為長文檔 OCR 的升級版本,用於應對超長文本在推理效率與穩定性上的要求。
官方同時指出,長上下文識別場景仍面臨顯示記憶體佔用隨文檔長度上升的壓力,需要持續優化推理效率,方可支撐超長文本的穩定識別與轉寫。