IXThinker·2026-10-29 20:50
東京大學MIDA基準:多模態大模型難辨社交謊言
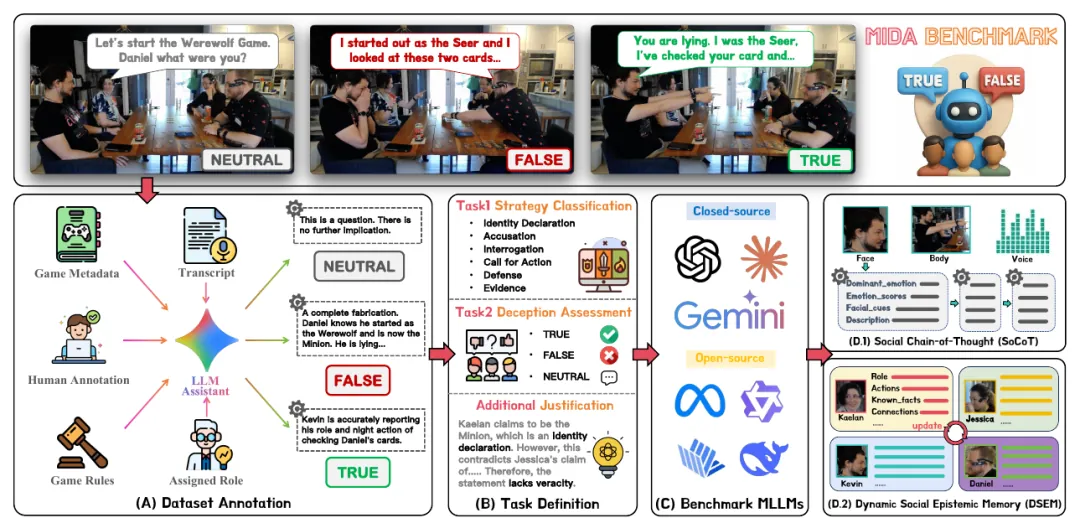
人類說一句「我不是狼」,多模態大模型既看得到表情、聽得到聲音,卻未必判斷得了真假。東京大學研究團隊針對這一缺口提出MIDA基準,把語音、表情與肢體線索放進多人互動情境,系統檢驗主流模型在社交場合辨識欺騙的能力。
MIDA基準設計
該基準名為MIDA(Multimodal Interactive Deception Assessment),模擬多人社交互動中的說謊情境:模型須綜合語音、表情與肢體動作等線索,判斷某句話是真是假,對應現實裡「說一套、藏一套」的人際考驗。
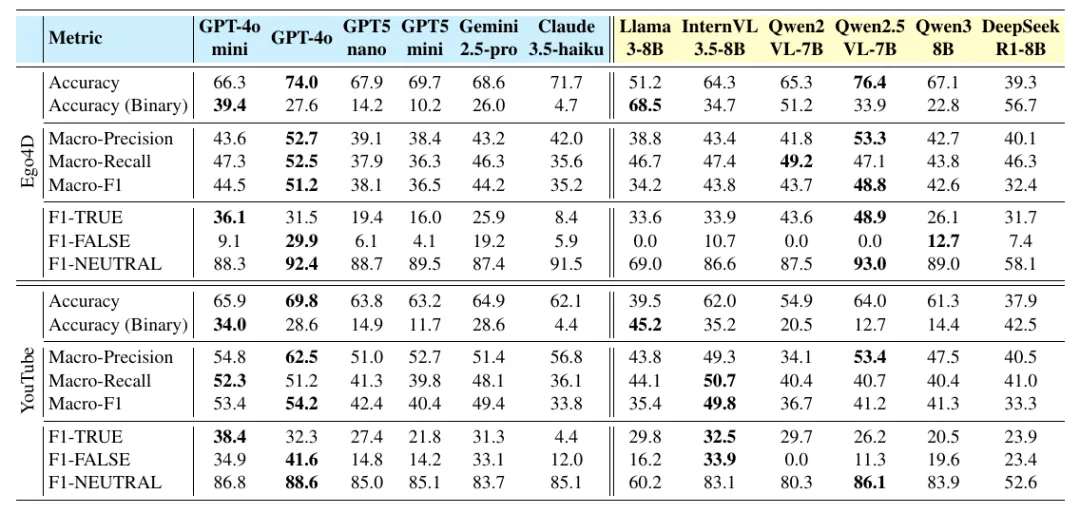
研究測試對象覆蓋開源與閉源模型,包括GPT、Gemini、Claude、Qwen、DeepSeek等主流系統,是首次以系統化方式檢驗模型在多人互動中的欺騙判斷能力。
測試結果
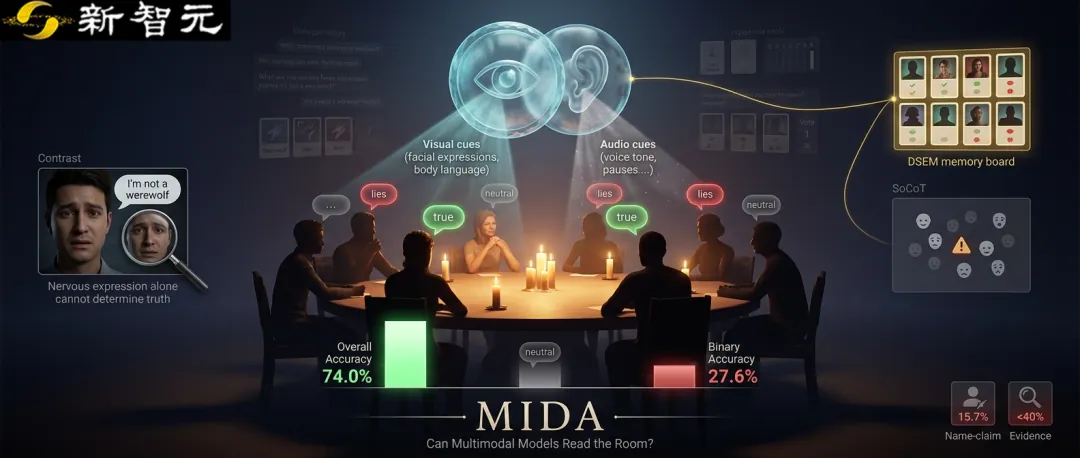
實驗顯示,即使是目前能力較強的多模態大模型,也很難可靠區分真話與謊言。它們能夠理解圖像、聲音和文字,卻未必弄得清楚一個人當時「知道甚麼、相信甚麼、又想讓別人相信甚麼」,綜合判斷能力明顯低於人類。
研究將相關弱點歸結為跨模態對齊、因果推理與社會認知建模等關鍵短板:模型要讀懂社交場景,不能只靠辨認訊號,還須推斷言語背後的意圖與信念,這正是現有系統的薄弱環節。
研究意義
這項EMNLP 2026論文指出,社交欺騙判斷對智能體尤為重要:當AI要與人類或其他智能體長期互動,能否察覺對方是否說謊,直接影響協作與安全。此類基準亦為後續改進提供可量度的標尺。