IXThinker·2026-10-29 18:20
螞蟻推出PolyOCR:2B參數全場景文本智能
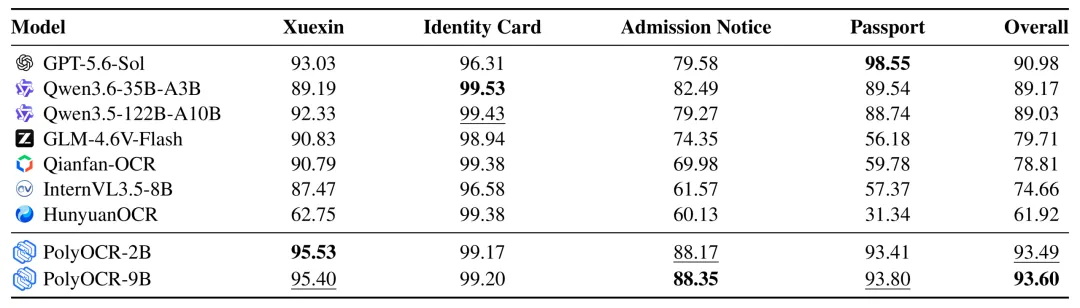
隨著多模態大模型能力提升,傳統OCR的短板反而更加明顯:真實業務中模型面對的往往是一張卡證、一份報表或整頁合同,需要的不只是文字,還有「哪個字段是甚麼、數字從何而來」。螞蟻AI安全實驗室提出OCR大模型PolyOCR。
為何OCR要升級
傳統OCR以識別文字為目標,但在真實業務中,模型接到的輸入是一張卡證、一份報表或一整頁合同,輸出要求則是「哪個字段是甚麼、數字從哪裡來」。僅能辨字的系統,難以支撐精確的文檔問答與業務判斷。
螞蟻AI安全實驗室認為,字符、位置、版式與字段關係共同決定模型「讀到了甚麼」,也決定它據此「能回答甚麼」;把它們放進一條連續的理解過程,才能衡量模型對業務材料的掌握程度。
技術方案解析
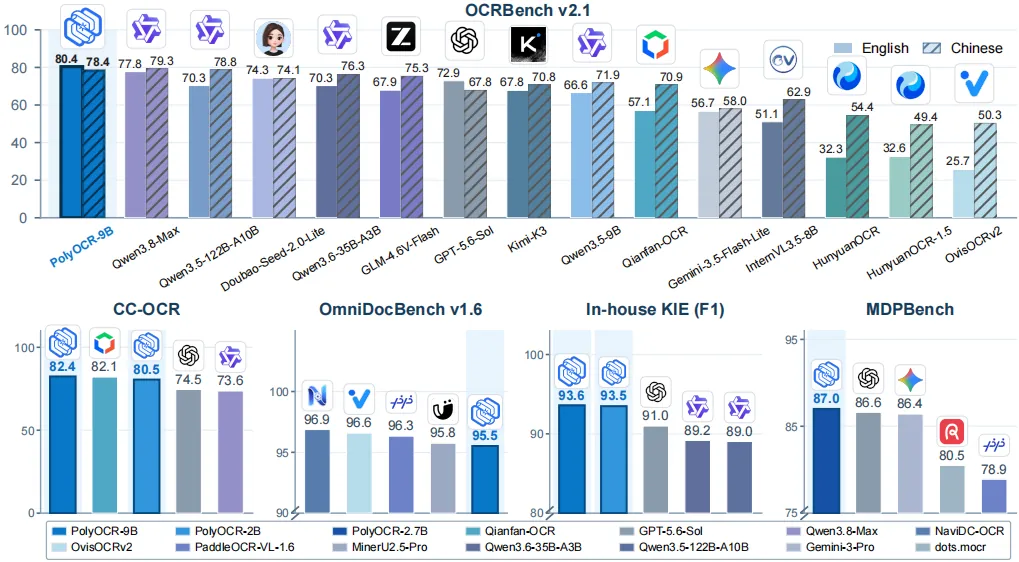
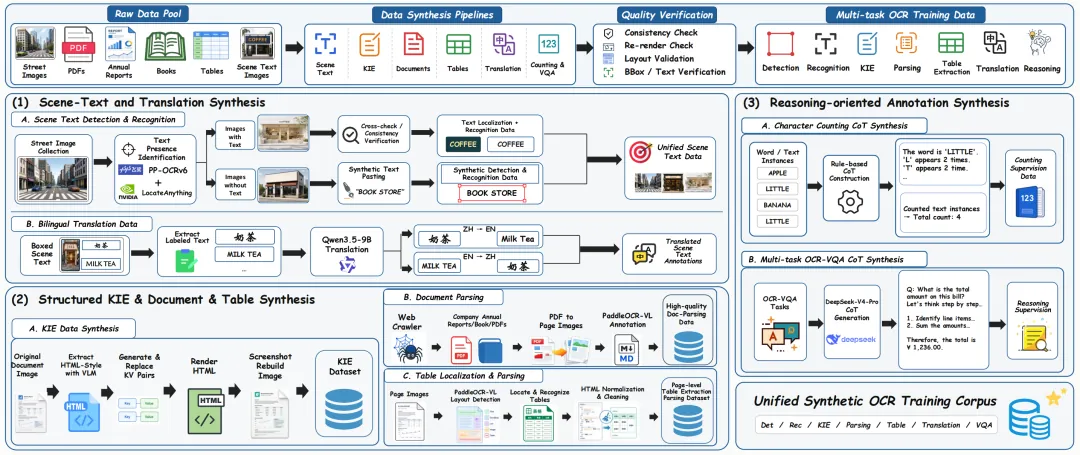
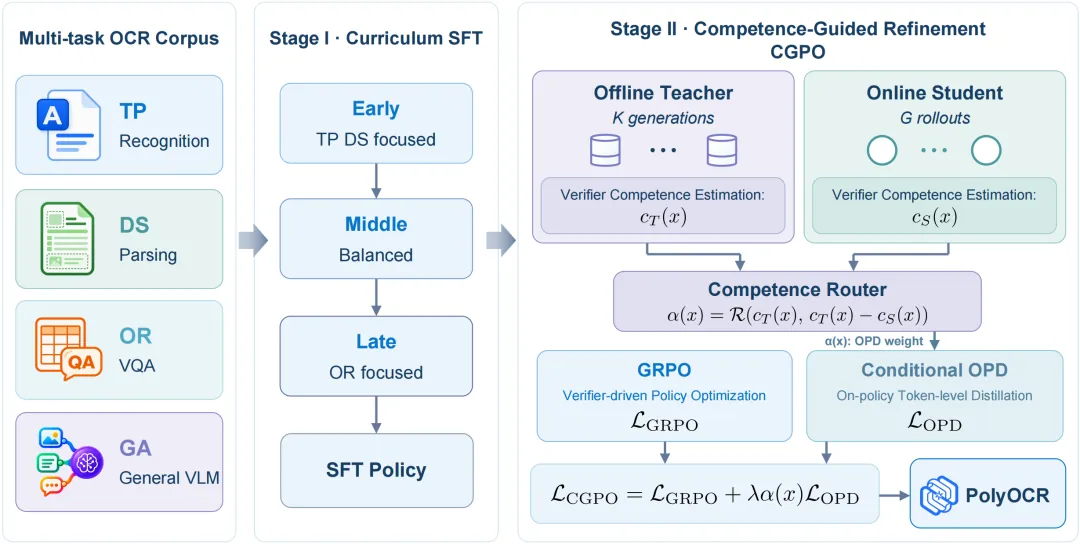
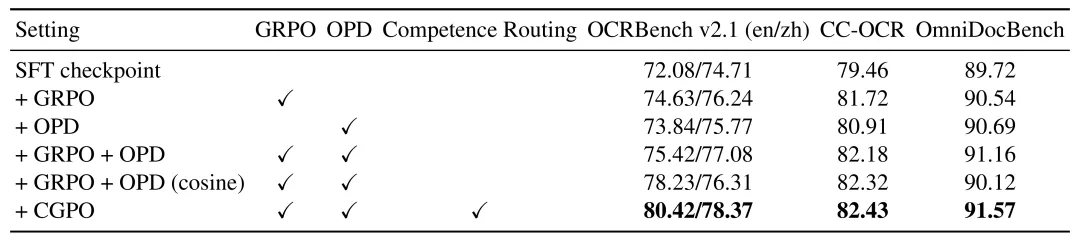
PolyOCR標榜同一架構覆蓋全場景文本智能,並以能力引導策略優化算法CGPO,將在線策略蒸餾與強化學習結合,為大模型裝上「讀懂文檔」的底層能力。該模型參數規模為2B,主打在有限規模下兼顧精度與效率。
應用價值
面向卡證、報表、合同等真實業務文檔,這類能力可讓模型準確解析字段語義、數值來源與結構關係,支撐高精度且可解釋的文檔理解,對需要處理大量業務材料的企業應用具參考價值。