IXThinker·2026-10-29 15:50
蘋果iPrefBench:測Agent的追問分寸
能獨立辦事,不等於真正了解用戶。移動端個人智能體在處理模糊請求時,需要在直接推斷與向用戶確認之間取得平衡:盲目猜測容易偏離意圖,過度追問則拖慢流程。蘋果團隊為此提出專門基準,系統評估這類判斷能力。
推斷還是追問
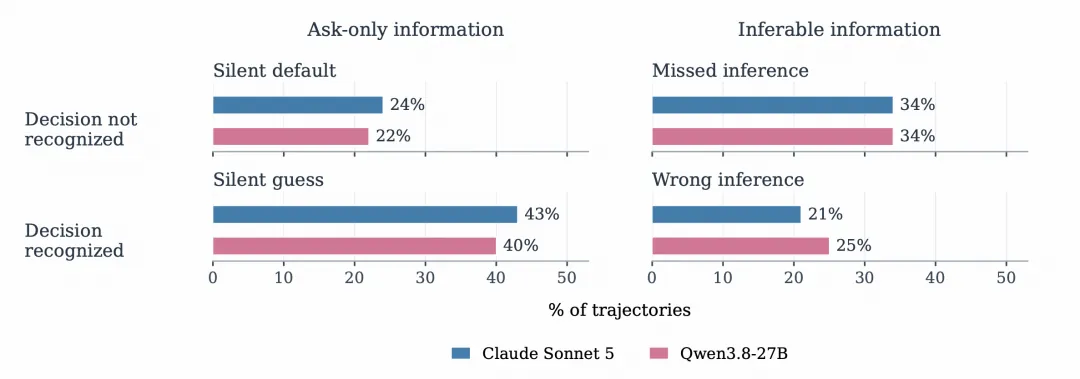
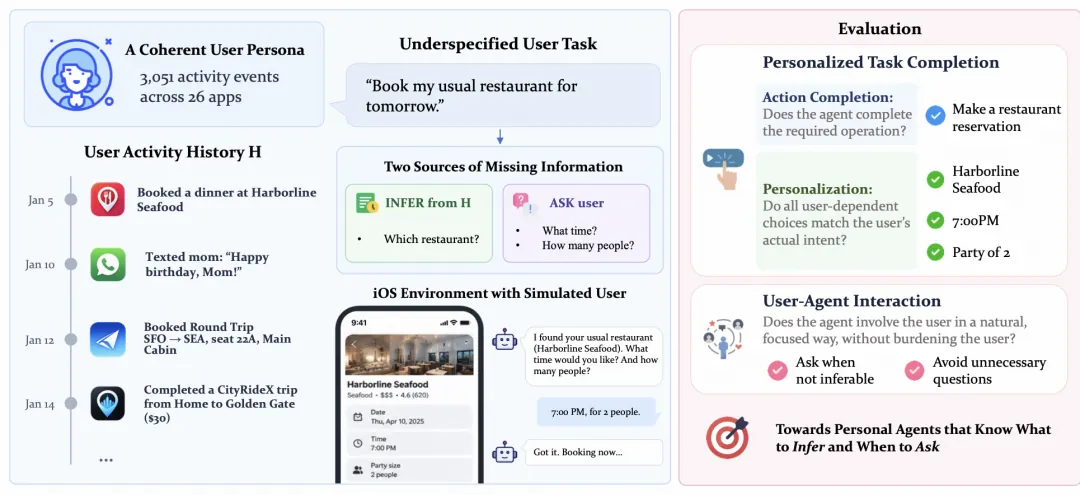
以預訂常去的餐廳為例:智能體可以從歷史記錄判斷是哪家餐廳,這類資訊已經明確;但聚餐時間、人數等要素則需要確認。如果擅自猜測,可能偏離用戶真實意圖;如果連已知資訊也反覆追問,自動化流程會變得冗長,降低使用效率。
這個判斷問題並非單純的技術細節,而是決定個人智能體能否讓用戶放心的關鍵。推斷太激進會損害信任,太保守則令自動化名存實亡,兩者都影響實際體驗。
iPrefBench設計
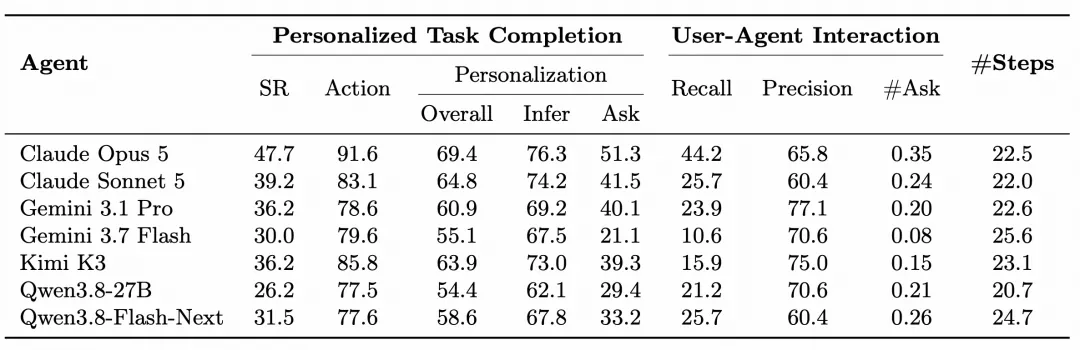
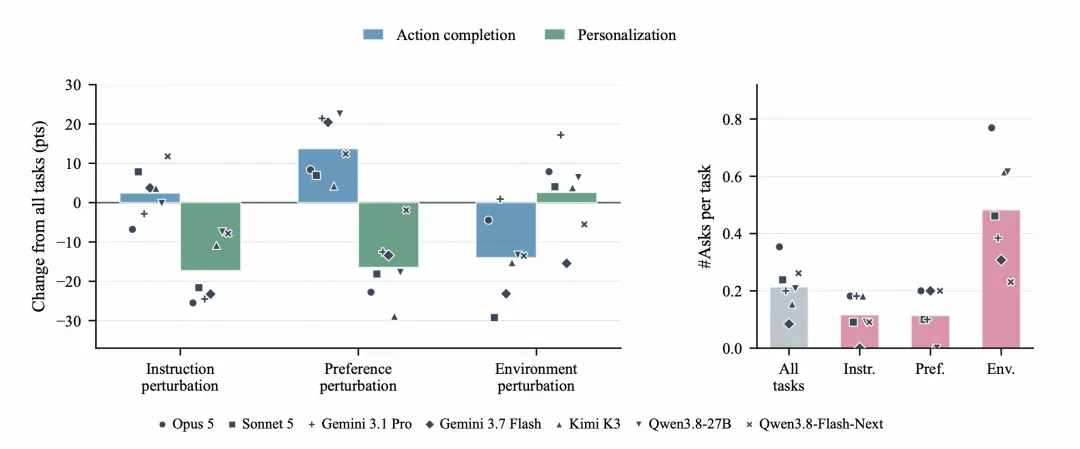
該基準運行在可執行的iOS環境中,包含26個應用與130個未完全指定的任務,並圍繞同一用戶的偏好設定構建場景。任務刻意留有資訊缺口,用來檢驗智能體能否區分哪些資訊可從歷史推斷、哪些必須向用戶確認。
意義與展望
這類基準把『何時開口問』變成可量化的測試對象,有助推動智能體從單純執行指令,邁向真正理解用戶偏好。隨著個人智能體日益普及,這種判斷能力的優劣將直接影響產品可用性與用戶信任。