IXThinker·2026-10-30 12:40
PSN-RLVR:參數擾動助模型跳出解題套路
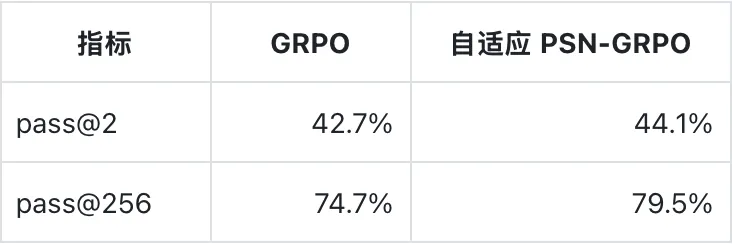
強化學習訓練令大模型答題更準,卻未必能解出更多題目。上海創智學院、復旦大學、上海人工智能實驗室與香港中文大學的研究團隊提出PSN-RLVR,在解題前為模型參數加入小幅擾動並貫穿整段推理,論文已獲NeurIPS 2026接收。
更準未必更廣
DeepSeek-R1等模型展示了強化學習提升推理能力的潛力,但已有研究發現,模型答得更準,未必意味着能解出的題目更多:訓練令模型愈來愈依賴熟悉的解題路徑,探索新思路的傾向隨之下降,限制了整體可解題的範圍。
參數擾動的設計
PSN-RLVR的做法是在解題前為模型參數加入小幅擾動,並讓同一擾動貫穿整段推理過程,效果如同暫時為模型換上一副不同的參數腦子,令慣常套路被輕輕推開,新的推理路徑有機會出現,而擾動屬臨時性質,維持在小幅範圍。
實驗結果
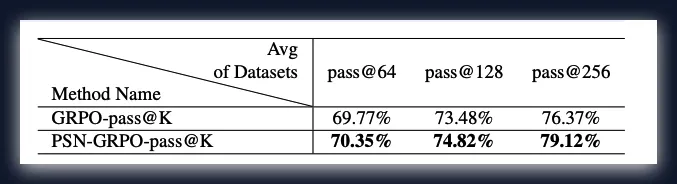
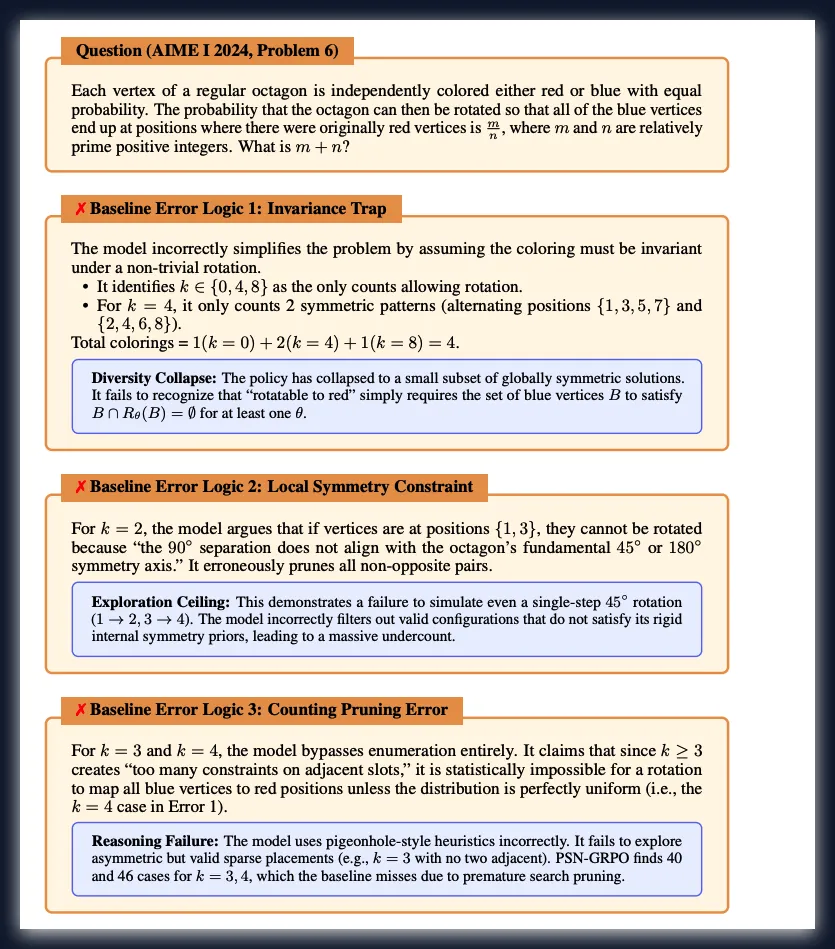
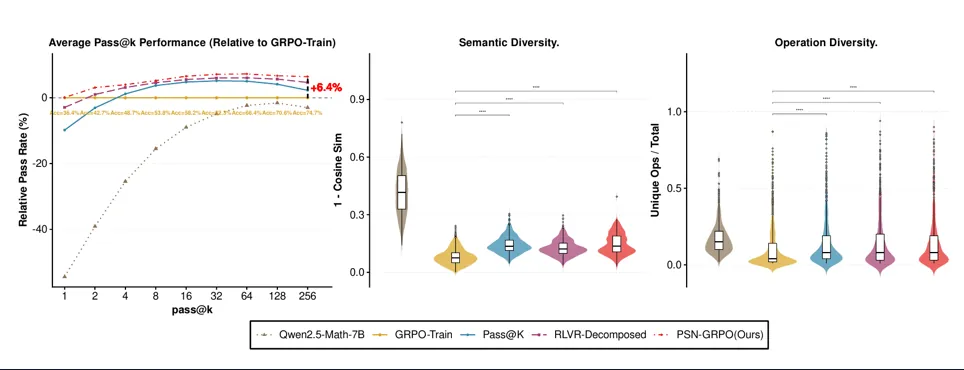
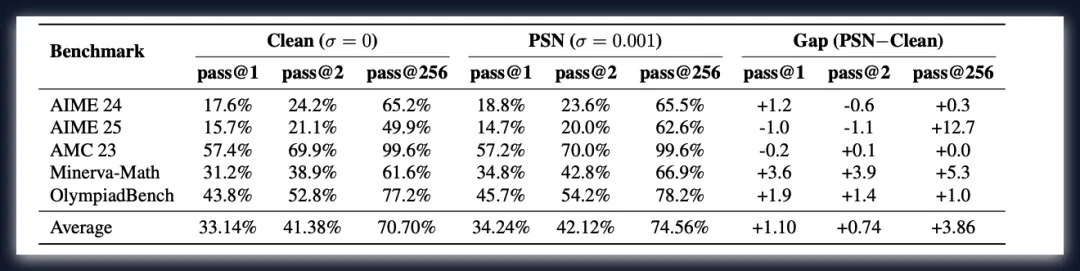
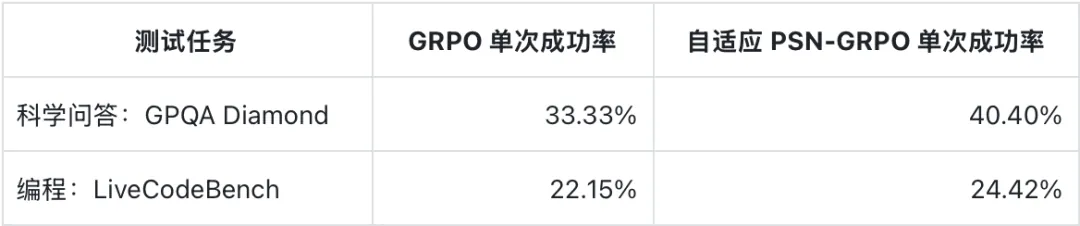
實驗顯示,該方法在多種模型上提高多次嘗試的成功率,於科學問答與程式編寫任務上取得分佈外泛化收益;研究人員亦觀察到基線多次採樣中未曾出現的解題思路,說明擾動確能引導出新的探索方向。相關論文已獲NeurIPS 2026接收。