IXThinker·2026-11-03 12:30
LeCun 團隊新成果:訓練方法勝堆參數
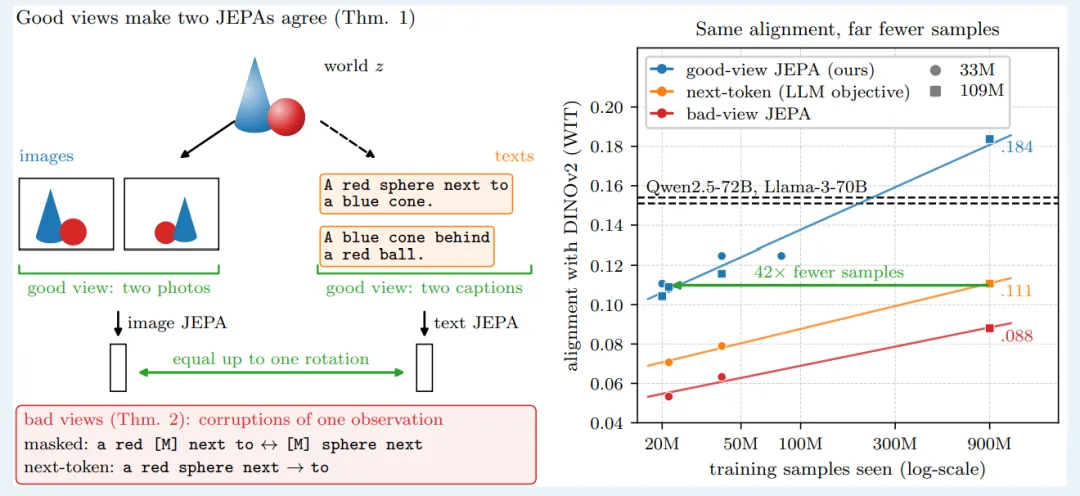
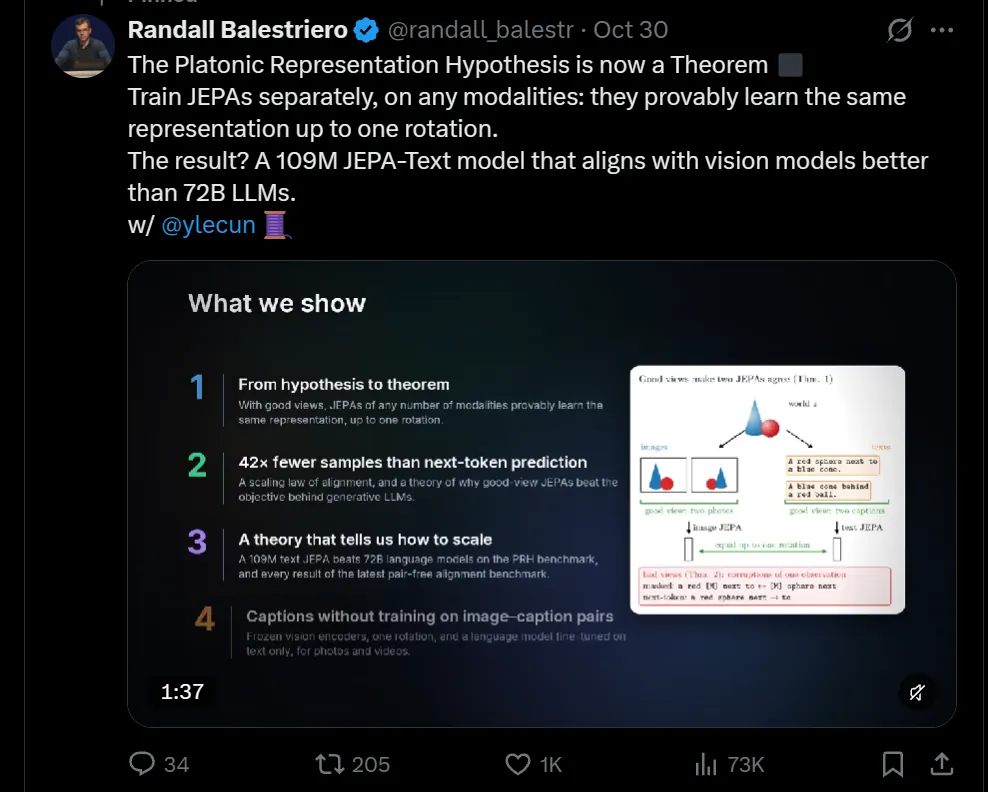
一項新研究結果顯示,僅 1.09 億參數的小模型在跨模態表徵對齊任務上,表現超越 720 億參數的 Qwen2.5;團隊並稱,換用新訓練方法後,達到同等效果所需訓練樣本量可降至原來的 1/42,結果屬該團隊主張。
660 倍差距的對比
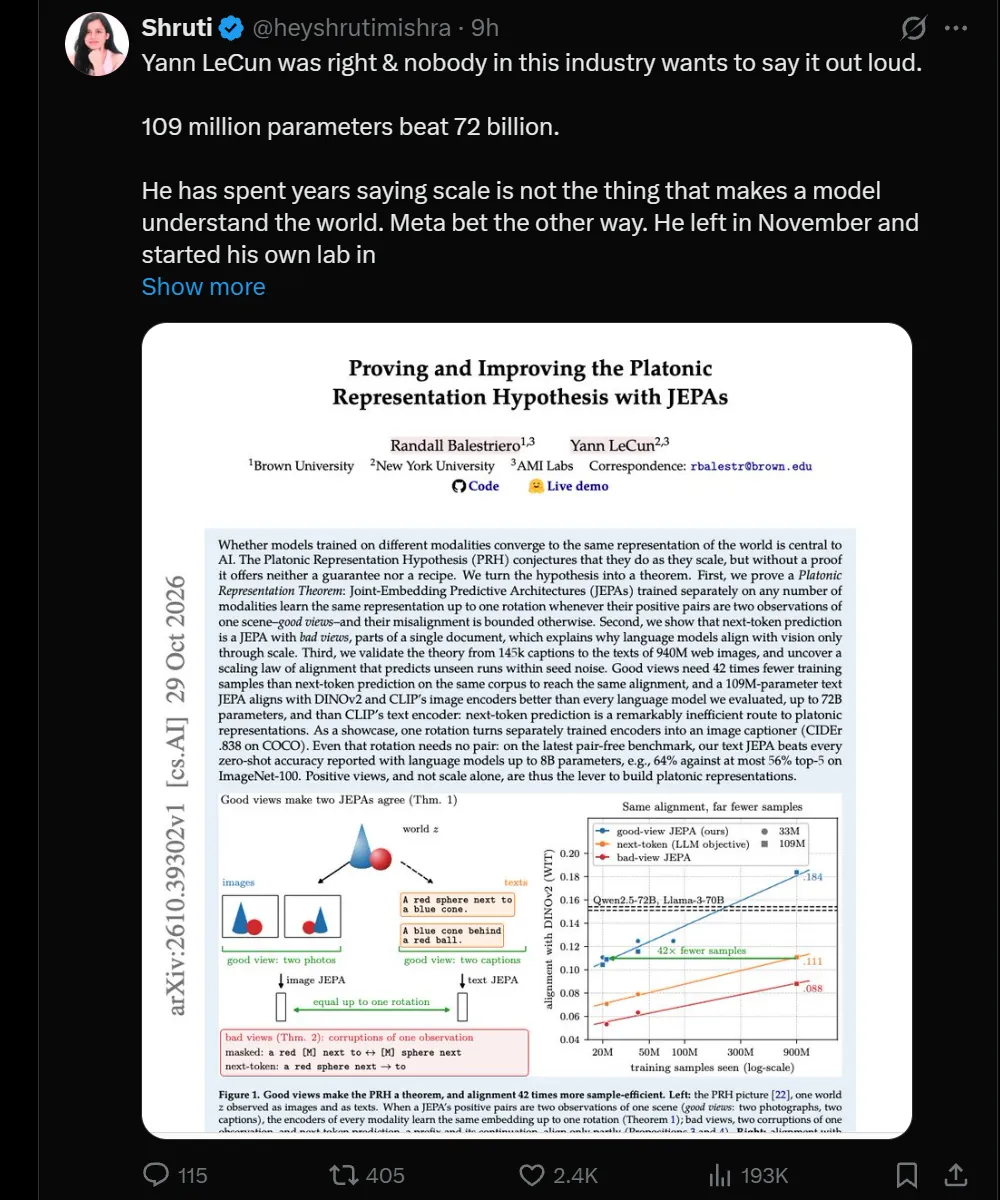
該研究的核心對比實驗,以一個僅 1.09 億參數的小模型,對上 720 億參數的 Qwen2.5,參數量相差約 660 倍。研究稱,在跨模態表徵對齊這項任務上,小模型的表現反而更佳。此項結果由研究團隊主張提出,一旦屬實,將對「模型必須做大才有效」的行業共識構成直接衝擊。
樣本量降至 1/42
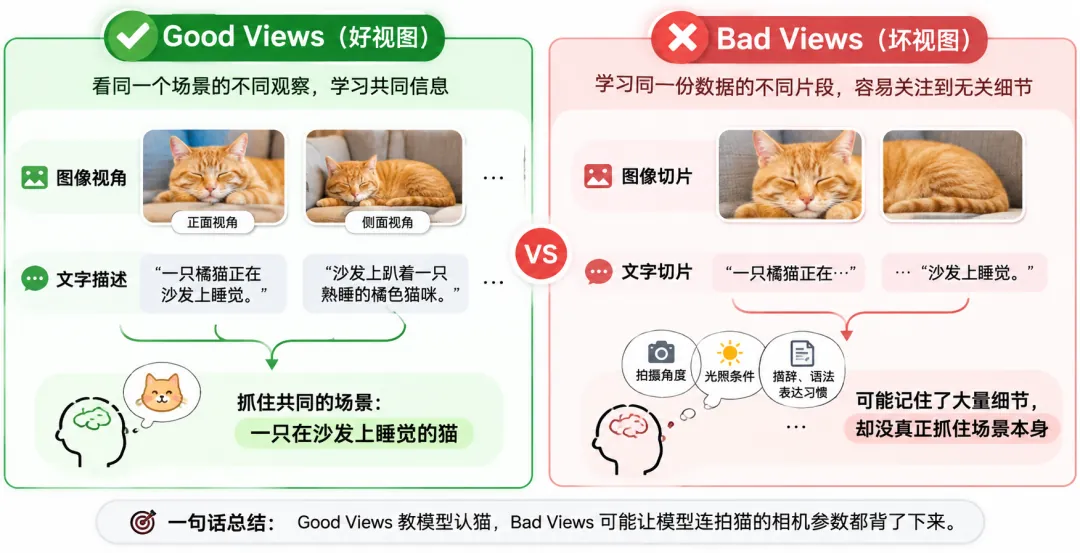
論文的另一發現涉及訓練效率:研究稱,當改換一套訓練方法後,模型達到同等效果所需的訓練樣本量,可大幅降至原先的 1/42,即在更少數據下達到相近表現。對長期「卷參數、卷數據」的大模型廠商而言,這意味著演算法與訓練策略的選擇,可能比單純擴大規模更具決定性。
LeCun 立場獲支撐
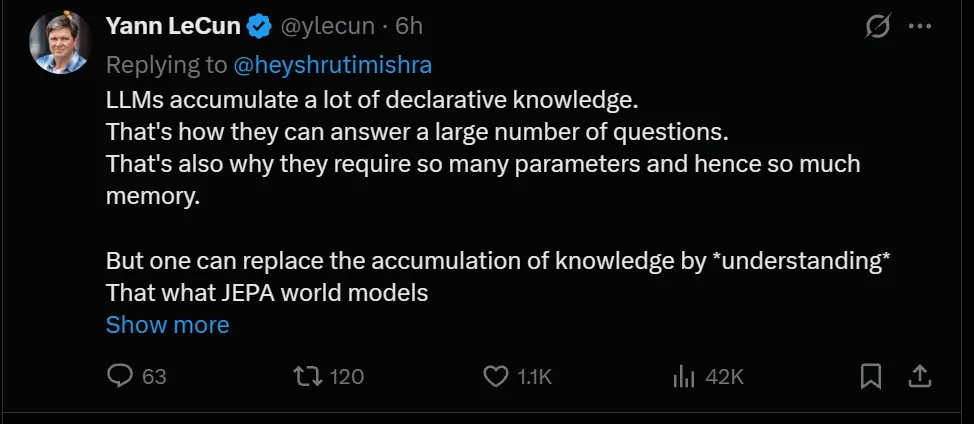
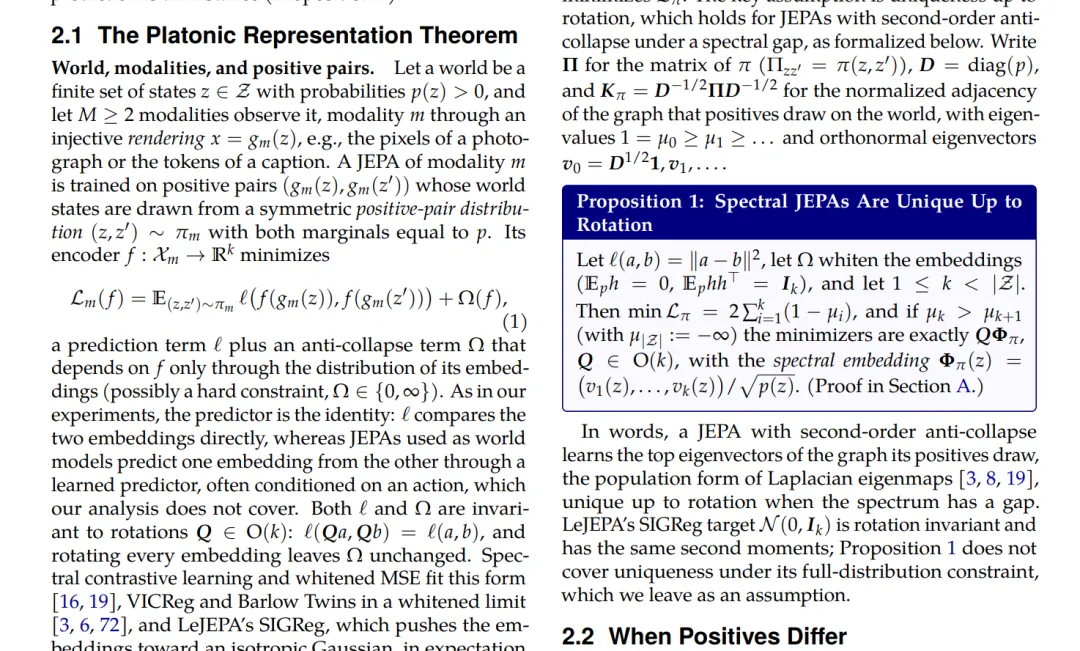
這項結果與 LeCun 多年來的主張互相呼應:他一直認為大語言模型固然強大,但主要依賴統計模式,並非理解世界的最佳路徑。論文以理論與實驗為這類觀點提供新依據,結論直指訓練方式的選擇可能比擴大規模更為關鍵;不過相關結果仍屬團隊主張,通用性有待更多任務驗證。
對業界的啟示
若結果獲進一步驗證,對業界的影響不容小覷:投入巨資堆參數與數據的路線可能面臨重新評估,而演算法層面的創新或成為更划算的競爭手段。當然,跨模態表徵對齊任務與通用能力仍有距離,小模型能否在更廣泛任務上複製優勢,仍是後續觀察重點。