IXThinker·2026-11-04 22:10
CoRL:機器人動作表徵語義錨定
發表於機器人學習會議CoRL 2026的論文,由北京大學王亦洲課題組與寧波東方理工大學、上海交通大學合作完成。研究聚焦視覺-語言-動作模型,追問什麼樣的動作表示才算好,並提出語義錨定機制,透過跨模態對齊把離散動作嵌入語義空間。
問題:表徵會退化
預訓練視覺-語言-動作模型從視覺語言模型繼承了豐富的語義表示,但在下游有限機器人示範數據上微調時,這一結構可能逐漸退化。研究由此提出基礎問題:什麼樣的動作表示才是好的動作表示。若動作嵌入偏離語義空間,模型的泛化與可解釋性都會受損。
鏡像神經元啟發
團隊的思路受鏡像神經元理論啟發。該理論認為,觀察與執行共享意圖層面的編碼,亦即大腦處理「看到別人做」與「自己動手做」時有共通的表示。這提示動作表示應當與語義意圖直接掛鉤,而非只在像素或坐標層面匹配,為語義錨定提供了理論依據。
語義錨定機制
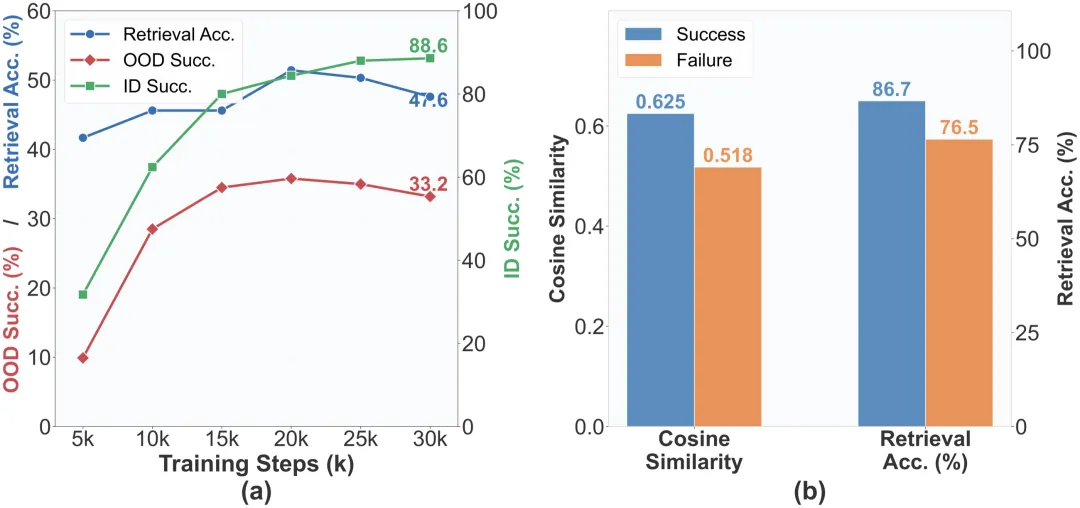
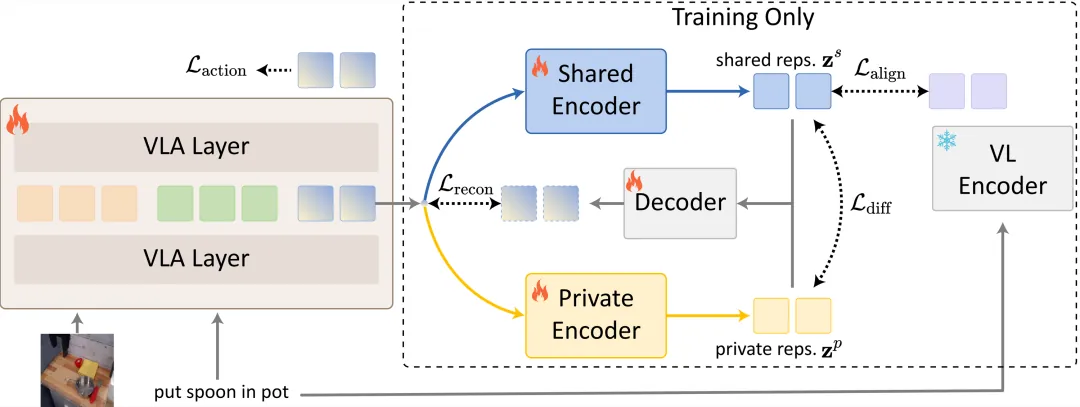
具體做法是透過跨模態表徵對齊,把離散動作嵌入到統一的語義空間,令每個動作帶有明確的語義錨點。訓練過程中動作表示被固定在語義結構附近,減輕有限示範數據微調帶來的退化,同時保留視覺語言模型原有的語義理解能力,讓動作選擇更容易被人解讀。
實驗結果
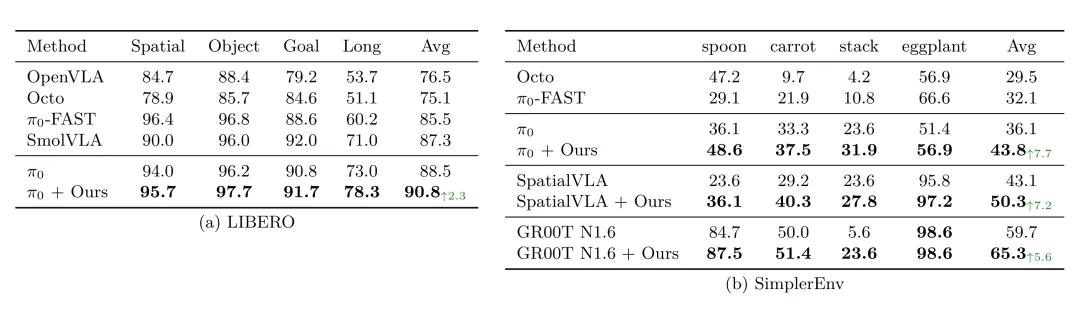
在多任務機器人操作基準上,加入語義錨定的方法相較基線取得明顯優勢,任務成功率與跨任務泛化均有提升。研究指出,動作嵌入與語義空間對齊後,模型在訓練數據有限的情況下仍能保持穩定表現,為具身智能中的動作語義建模提供了一條可行路徑。