IXThinker·2026-11-05 21:10
斯坦福CS 329Z第三講拆解RAG全流程
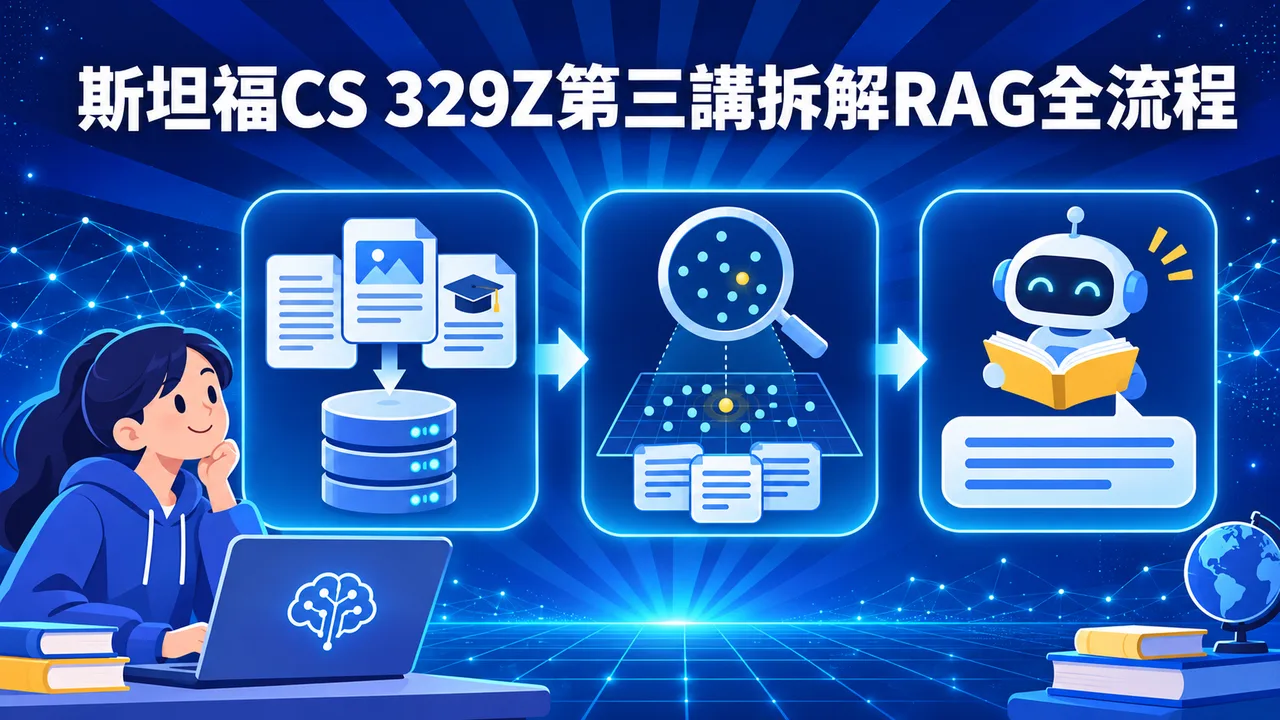
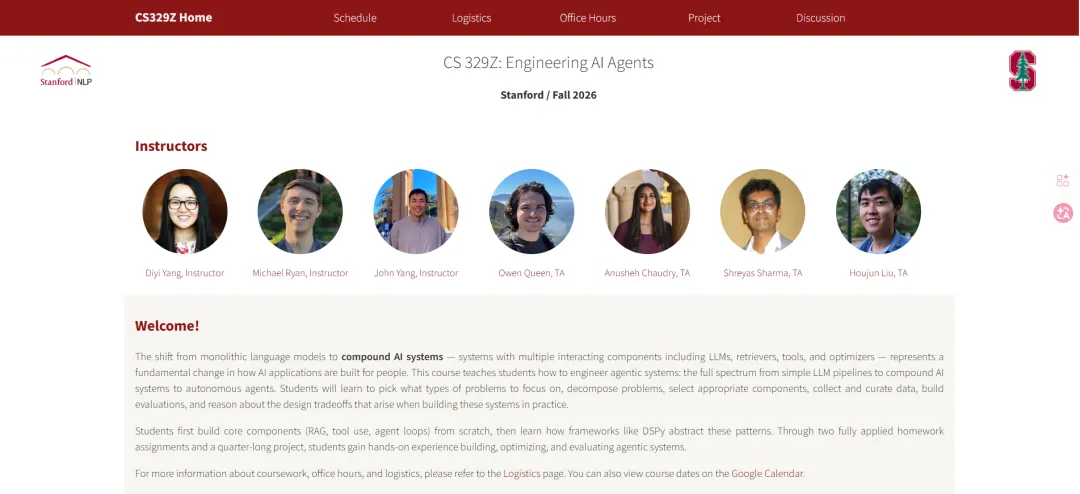
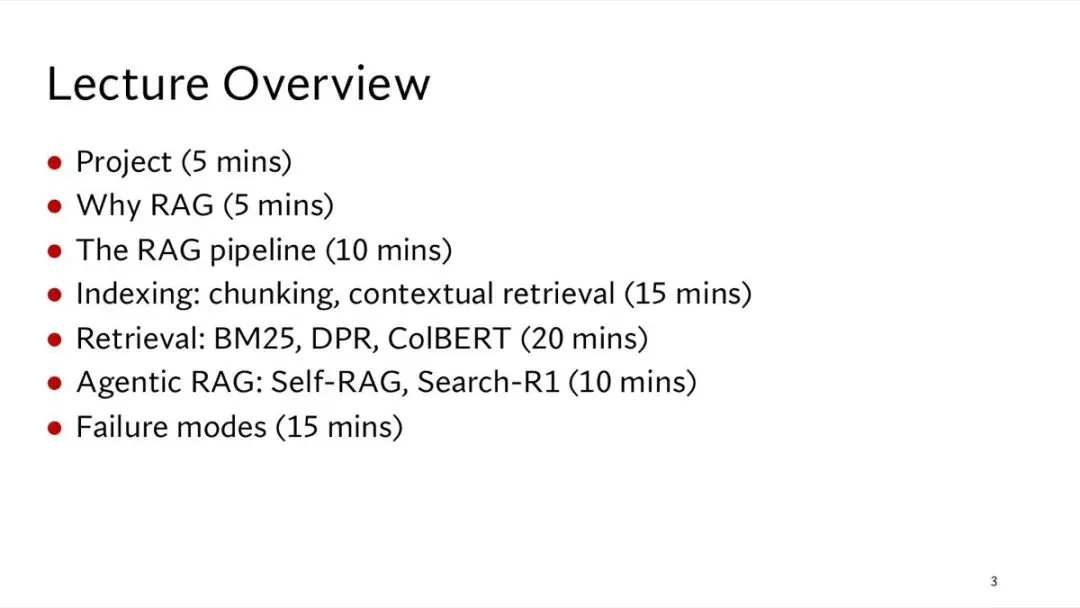
斯坦福2026年秋季CS 329Z《Agent工程》第三講以檢索增強生成為主題,由Diyi Yang主講,課件共63頁。這一講回答RAG流程怎樣搭建、在哪裏出問題、該給什麼建索引與如何檢索,並延伸到Agentic RAG與失敗模式。
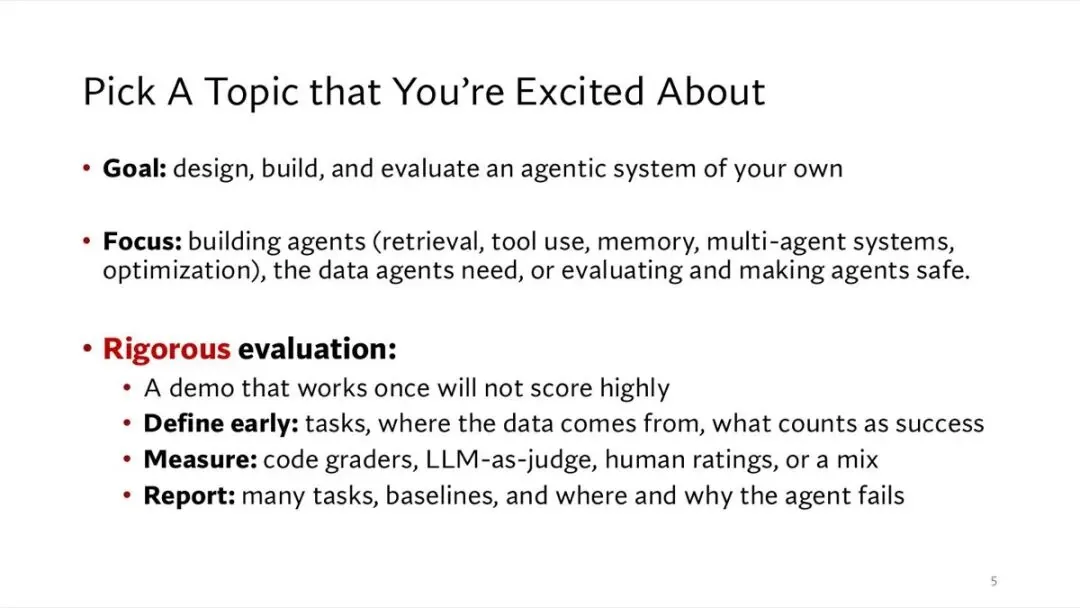
課程項目重視嚴格評估
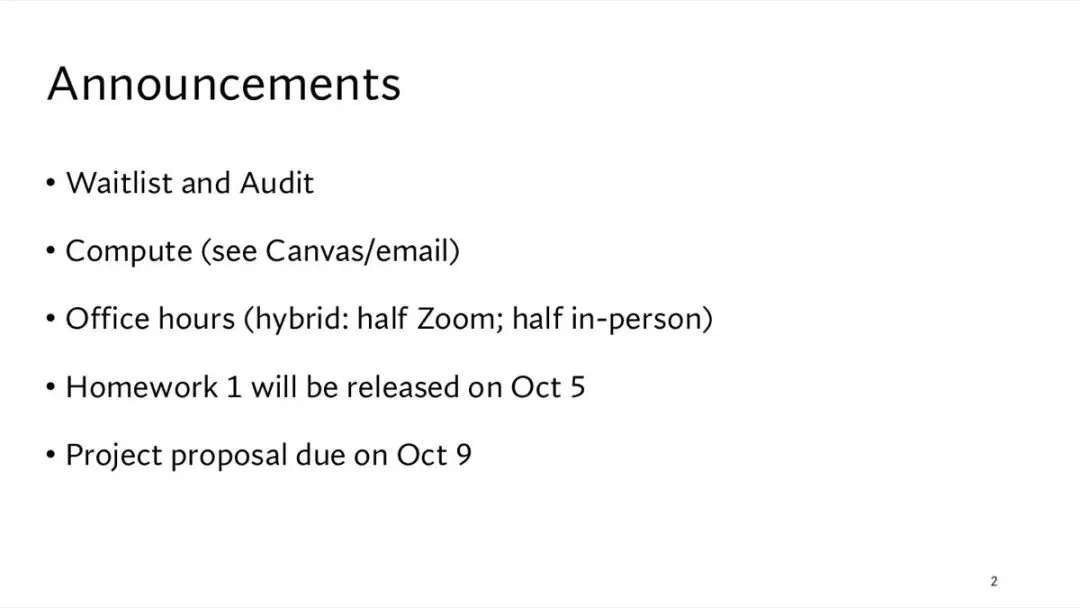
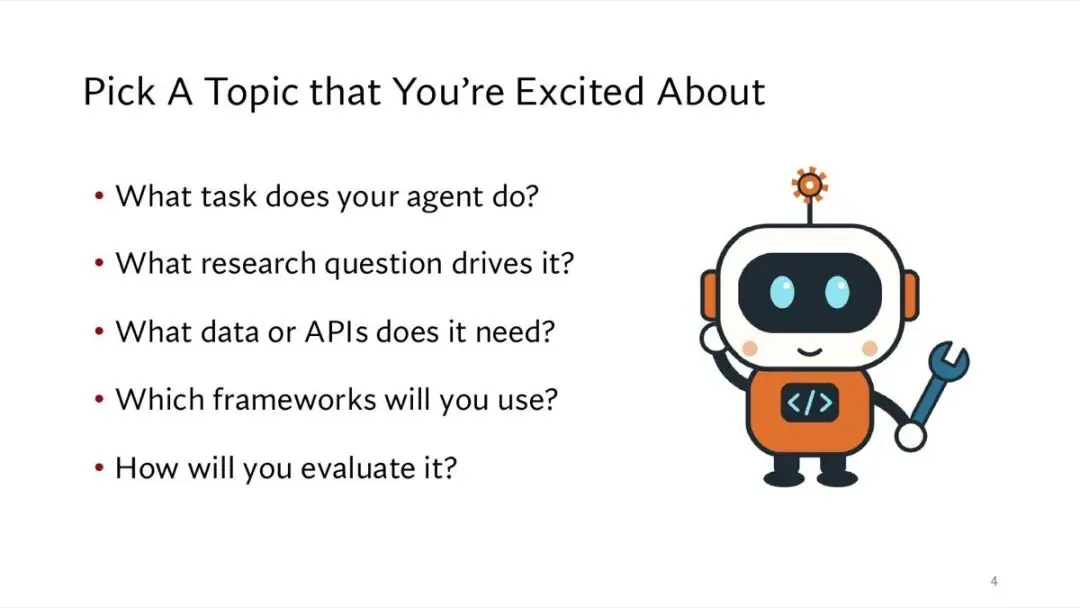
項目要求學生自行設計、搭建並評估一個agent系統,評估須做得嚴格,只跑通一次的demo拿不到高分。學生要儘早界定任務、數據來源與成功標準,可用代碼評分器、LLM當裁判或人工打分;報告須涵蓋多個任務、設基線,並交代失敗原因。作業一10月5日發布,開題報告10月9日截止。
RAG流程與成績
RAG由檢索器與生成器組成,兩者可一起訓練:只需正確答案,檢索器靠能否幫助寫出正確答案間接學習。檢索器以DPR為例,用兩個BERT分別編碼查詢與段落,以最大內積搜索取回前K段;生成器用BART,把查詢與檢到的文字拼接後逐token輸出。
成績上,RAG-Sequence在NQ數據集取得44.5的精確匹配分數,高於DPR的41.5與僅靠參數作答的T5-11B;Jeopardy出題任務的人工評估中,認為RAG結果更具事實性的受試者佔42.7%,遠高於BART的7.1%。課件並梳理了從進階到模組化的RAG變體。
建索引:切塊與上下文
切塊是檢索的基本單位:塊太小缺上下文,太大則把多個主題平均進同一向量。常見做法按100至500個token切分,塊間保留10%至20%重疊。上下文檢索讓LLM為每個塊補寫50至100個token的背景,配合混合檢索後,前20條檢索失敗率可由5.7%降至2.9%。
延遲切塊先用長上下文編碼器讀完整篇文檔再按塊池化,免卻額外調用;樹狀索引RAPTOR逐層聚類寫摘要,GraphRAG把文檔轉成知識圖譜再按社區總結,用以回答需綜合全局的問題;向量搜索則依靠IVF、乘積量化與HNSW等近似最近鄰方法提速。
三類檢索器各有所長
BM25靠詞重合打分,至今仍是使用最廣的方法,擅長錯誤碼、產品編號等精確字符串;DPR把問題與段落編碼為向量,在5個數據集中的4個勝過BM25,僅1000個問答對即可訓練;ColBERT為每個token保留向量、以MaxSim打分,重排序精度與BERT交叉編碼器相當而速度快得多。
兩類檢索器出錯的地方不同,可用倒數排名融合合併結果,再以交叉編碼器在短名單上重排。課件對比顯示,BM25查詢延遲約62毫秒,ColBERT端到端458毫秒,BERT-base重排序則需逾一萬毫秒。
檢索進入Agent循環
課件指出,此前的技術只處理單一問題。Self-RAG讓模型學會輸出反思標記;CRAG由評估器給檢索結果打分,錯誤時改寫查詢上網補搜;Search-R1以強化學習學會多輪搜索。以Qwen2.5-7B為基座,其在NQ的精確匹配為0.480,高於普通RAG的0.349。
失敗模式分三側
RAG的問題歸為三側各三種:檢索側有召回上限、索引過期與權限泄漏;閱讀側有迷失在中間、干擾內容與證據衝突,其中迷失在中間指相關信息落在長上下文中部時表現明顯下滑;循環側有錯誤累積、缺少停止規則與提示注入。下一講定於10月5日,主題為工具使用與函數調用。