IXThinker·2026-11-06 19:00
斯坦福Agent工程課第4講拆解工具呼叫
斯坦福CS 329Z《Agent工程》第4講聚焦工具呼叫。繼第3講拆解RAG全流程後,本講接續收尾RAG的長上下文與引用問題,再逐層講解工具的定義、模型自學調用、海量API擴展、標準接口與評測體系。
為何需要工具
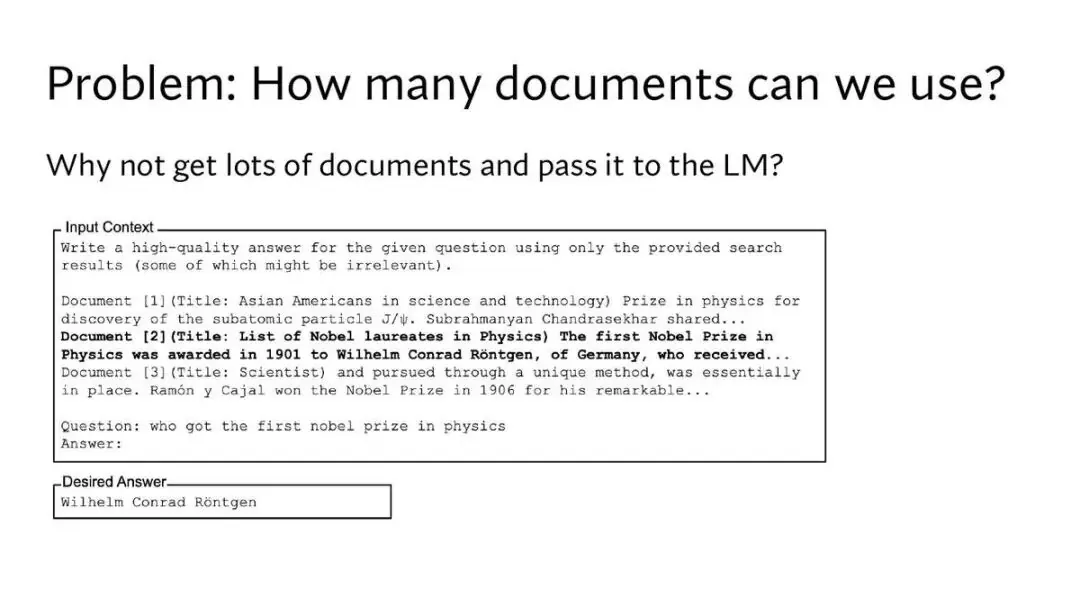
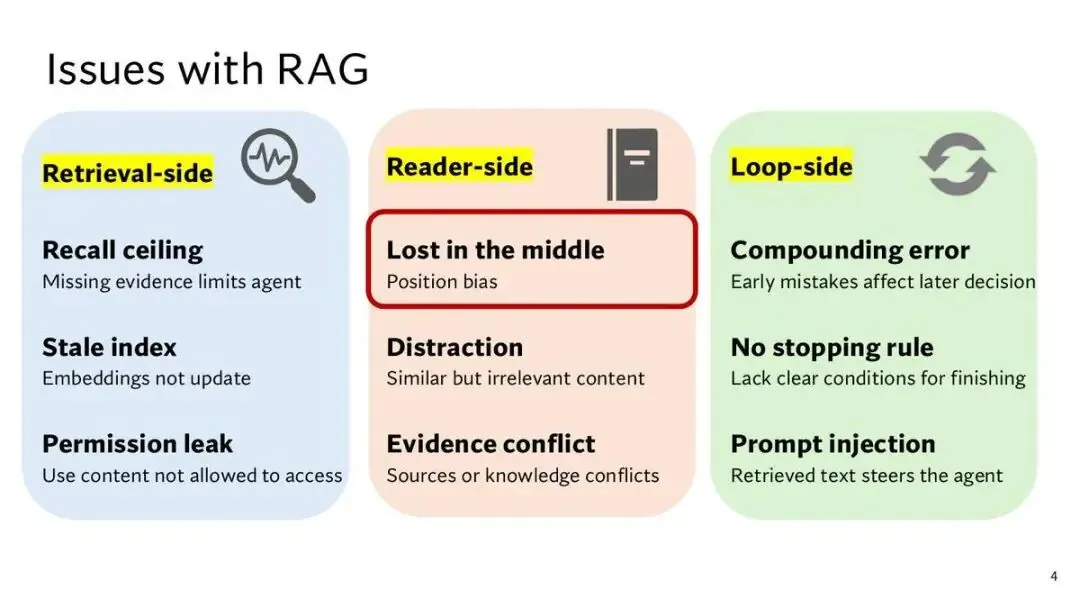
課程先收尾上一講RAG的遺留問題:長上下文中段的文檔易被模型忽略,多項測試顯示答案置於開頭或結尾時準確率最高;生成式搜索引擎的引用也可能失實,學術投稿中已出現不存在的文獻。
至於為何要工具,課程舉例指出乘法是典型短板:GPT-4乘法準確率僅59%,位數增加後準確率趨近零;長尾事實、訓練截止後的資訊及私有數據,也需要搜索、即時API與內部檢索補足。
模型自學調工具
Toolformer讓模型自行決定調用哪個API、何時調用與傳入什麼參數:先採樣候選調用並執行,再以損失過濾,只保留能降低後文預測成本的調用,最後用過濾後的數據微調60億參數模型,在事實補全、數學與時間類任務上超越1750億參數的GPT-3。
ToolkenGPT則把每個工具視作一個新詞元,只為工具學習嵌入向量,新增工具不必重訓整個模型;模型生成詞元後切換到工具模式補全參數,執行完再帶着結果繼續推理。
海量API防幻覺
工具數量增多後,模型容易編出不存在的API。ToolLLM在超過1.6萬個API上訓練,並配備檢索器先找出相關文檔;Gorilla在1645個API調用上生成16450對指令數據訓練7B模型,通過檢索感知訓練讓模型在檢索質量不佳時也不易被帶偏。
Gorilla另以抽象語法樹子樹匹配量化幻覺,把生成調用解析成鏈並與API數據庫對照,能區分「編出不存在API」與「選錯API」兩類問題;評測顯示其在多個模型庫上準確率最高、幻覺率最低。
標準接口三代演進
早期方法每新增一個API便要再訓練一次;標準接口改為在運行時提供schema。第一代REST面向人,模型需自行讀文檔、手寫請求;第二代函數調用面向模型,每個工具一份JSON schema,由外層程序校驗並分發;第三代MCP面向生態,寫一次便能在不同宿主應用間復用。
MCP由Anthropic於2024年11月發布,2025年12月捐贈予Linux基金會旗下新基金,本講必讀正是該協議規範;透過tools/list發現工具、tools/call執行,鑒權分入站與出站兩層。
評測與失敗模式
評測分三層:BFCL量度單次調用,榜首Claude-Opus-4-5總準確率77.47;ToolBench測多步調用鏈;τ-bench檢驗工具、Agent與用戶三方互動,以pass^k量度穩定性,gpt-4o零售與航空平均48.2,各模型在航空領域均未超過36。
課程把失敗模式分三層:單次調用可能選錯工具、編造參數或幻覺出不存在的API;多步鏈路易順序出錯,一個調用失敗後不懂改道;對話層面則涉及違反領域規則、該問不問自行假設,以及重試結果不穩等問題。