IXThinker·2026-11-06 13:30
首個互動式投影對齊基準 測試模型3D位姿感知
人類能從二維投影推斷三維結構,並據此預判旋轉帶來的輪廓與遮擋變化。廈門大學與南洋理工大學團隊提出RoTA-Bench,把這種由視覺理解轉化為精確旋轉控制的能力,放進可逐步交互的閉環環境中評測。
任務規則:旋轉對齊輪廓
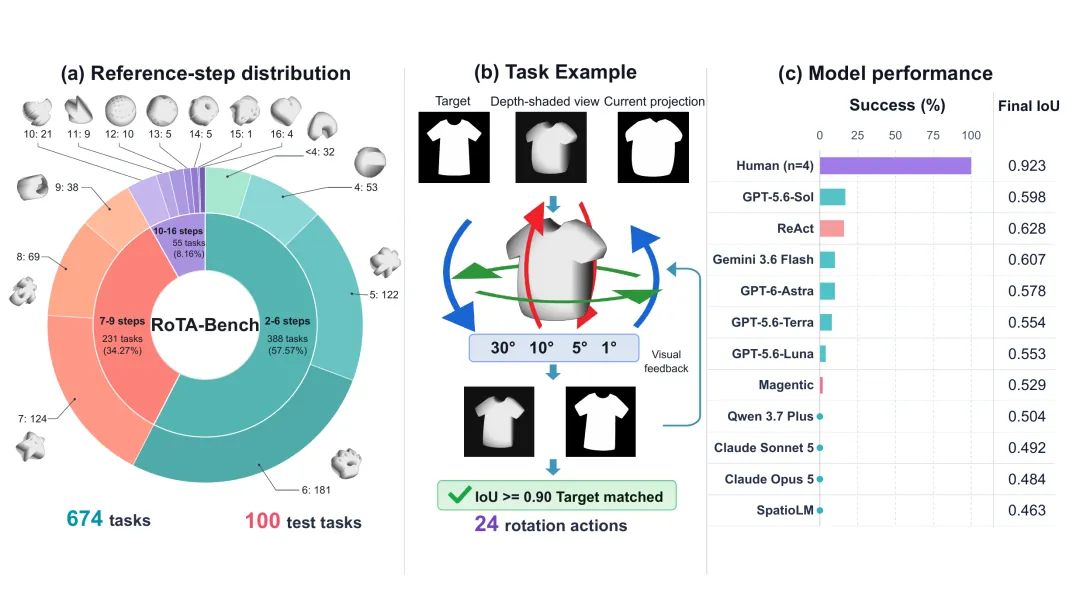
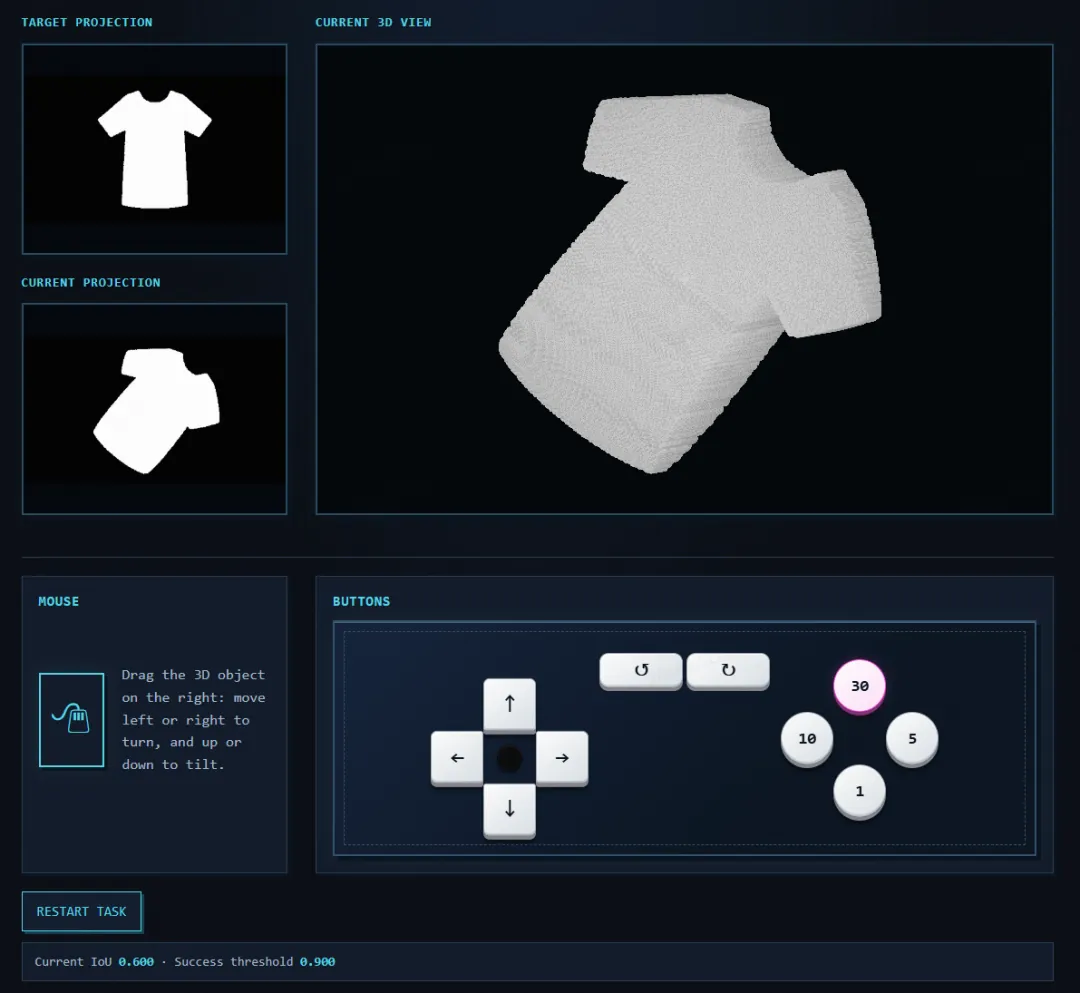
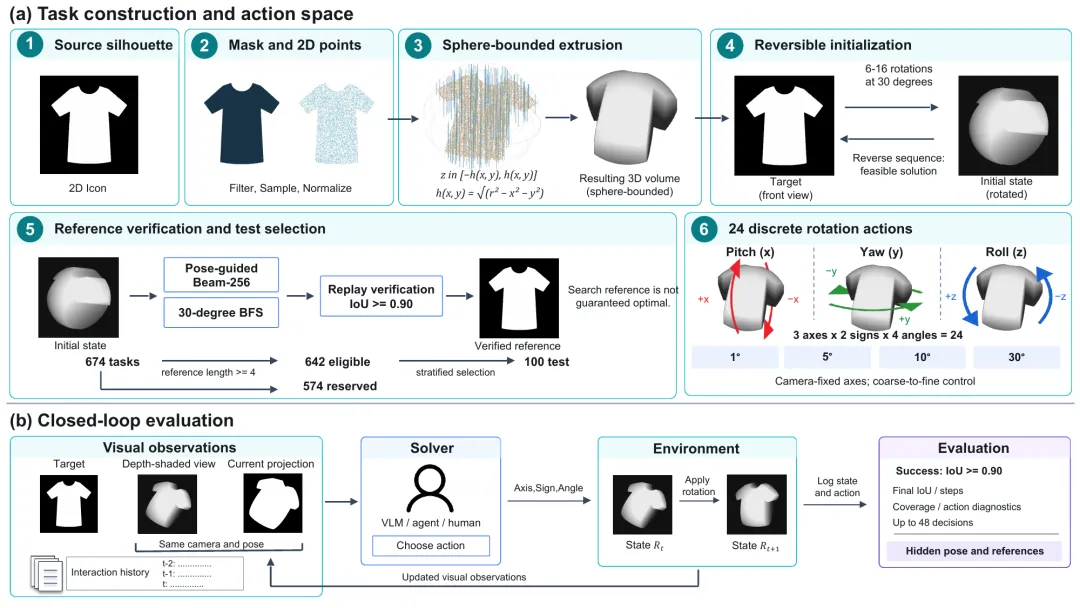
任務要求模型逐步選擇旋轉動作,令物體當前投影與目標輪廓的交並比達到0.90。每一步模型可看到目標輪廓、當前投影及深度明暗輔助視圖三項信息,並從三個旋轉軸、正反方向與1度、5度、10度、30度四種步長組成的24種動作中選一項;每次執行後環境重新渲染畫面,最多允許48次決策。
為避免模型借助熟悉形狀的語義先驗,研究人員從二維矢量圖標出發,在球形體積約束內構造三維物體,並以一串可逆的離散旋轉設定初始姿態,使任務從構建上保證可解。基準共含674個任務,其中100個組成凍結測試集,其餘574個留作後續訓練與研究。
人類與模型差距明顯
研究人員測評9個視覺語言模型及2種智能體配置,並邀請20位本科生參與人類實驗,雙方使用相同任務、動作空間、決策預算與成功標準。在100個測試任務上,表現最好的GPT-5.6-Sol成功率為17%;人類合共400次運行全部成功,模型軌跡的交並比多停在0.50至0.63附近。
拆解錯誤:方向與角度
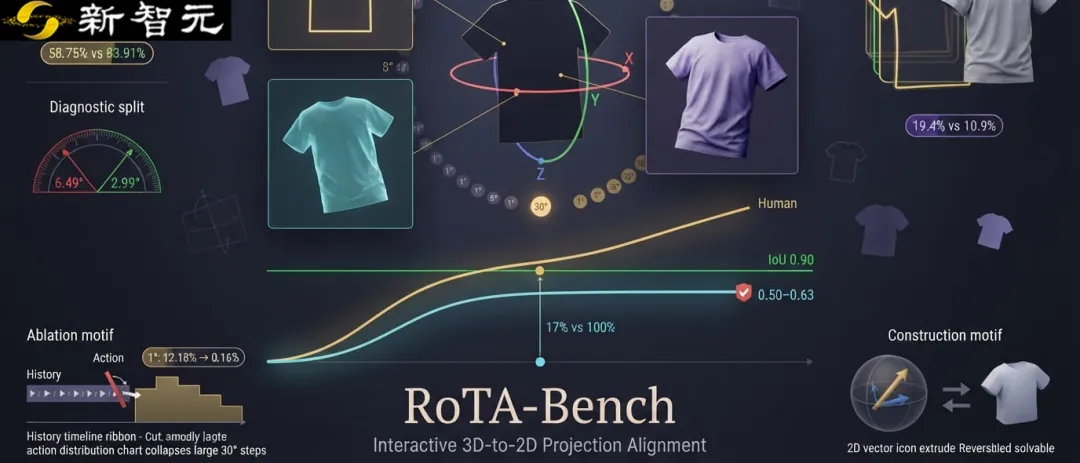
進一步診斷顯示,模型困難並非源於觀察不足:GPT-5.6-Sol累計表面觀察覆蓋率為79.58%,人類為83.07%,兩者接近。把每步旋轉拆成方向與角度兩項選擇後,模型選出能有效減小三維姿態誤差方向的比例為58.75%,人類為83.91%,與均勻隨機的53.78%相距不遠。
在已選中的有效方向內,模型平均角度誤差為6.49度,人類為2.99度;選中最優合法角度的比例,模型為61.80%,人類為71.82%。兩類誤差疊加,構成動作層面的主要差距,顯示模型不僅難選對方向,沿正確方向亦欠缺精細調整。
輪廓改善未必姿態更準
研究人員從人類與模型軌跡中配對211個相同姿態的狀態。模型有19.4%的動作令輪廓重疊改善、姿態對齊卻變差,人類為10.9%;人類亦更常選擇暫時降低投影重疊但減小姿態誤差的動作,佔33.2%,模型為23.7%。由於不同姿態可產生相似投影,二維畫面的局部改善與姿態誤差縮減並不同步。
互動歷史影響精細控制
在30個任務上的輸入消融實驗中,保留完整輸入時GPT-5.6-Sol完成5個;移除交互歷史後成功數降為零,30度大幅旋轉的佔比由62.75%升至96.76%,1度微調幾乎消失。歷史信息對轉多大角度的影響,明顯大於對往哪個方向轉的影響,反映模型的精細控制依賴此前的觀察紀錄。