IXThinker·2026-11-05 15:50
獅子山實驗室發布 35B 具身推理模型
視角變化混淆物體身份、誤判鏡頭運動、錯估任務進度,是機械人執行現實任務的常見失敗源。獅子山人工智能實驗室近日發布具身推理視覺語言模型馭物,以能力牽引的數據引擎取代盲目堆數據,讓模型讀懂三維物理世界。
視覺表象的陷阱
畫面中物體位置看似更高,不等於在真實三維空間更高;拍攝角度改變,家具外觀變化但仍是同一物體;畫面內物體移動,可能是物體本身移動,也可能只是鏡頭轉動。這些差異人類一眼可辨,卻是具身模型的難關。
過往 OpenX-Embodiment、DROID 等工作不斷擴大真實機械人數據規模,但既有研究表明,數據變多並不等於能力變強,僅調整不同數據域的訓練權重,即可明顯影響下游任務表現。
能力藍圖先定向
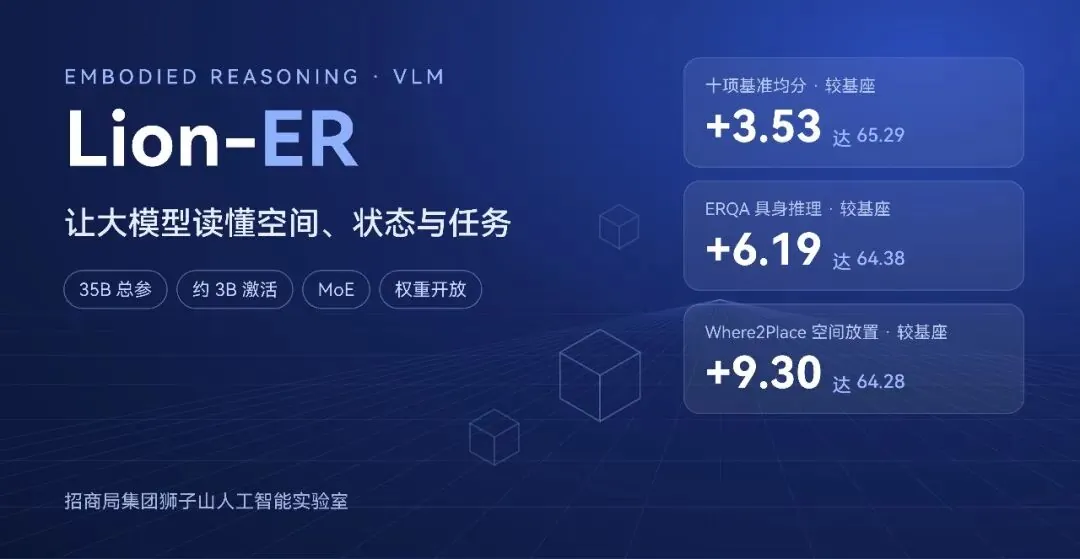
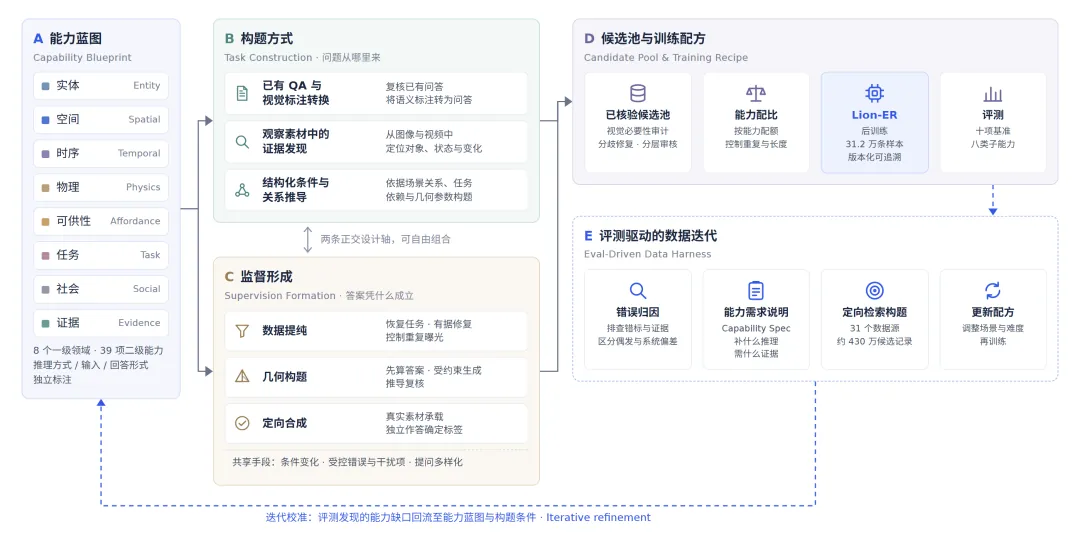
馭物採用混合專家架構,總參數約 35B,每個 token 僅激活約 3B。團隊將具身推理拆解為實體、空間、時序、物理、可供性、任務、社會、證據八個一級領域,再細化 39 項二級能力,並把推理方式、輸入形式與回答形式獨立標注。
藍圖同時界定各能力應在何種條件下調用,記錄複合任務中的主能力與輔助能力。訓練採樣時組合並留出不同因素,避免某類能力長期綁定少數固定場景、物體或提問方式。
題目有據可依
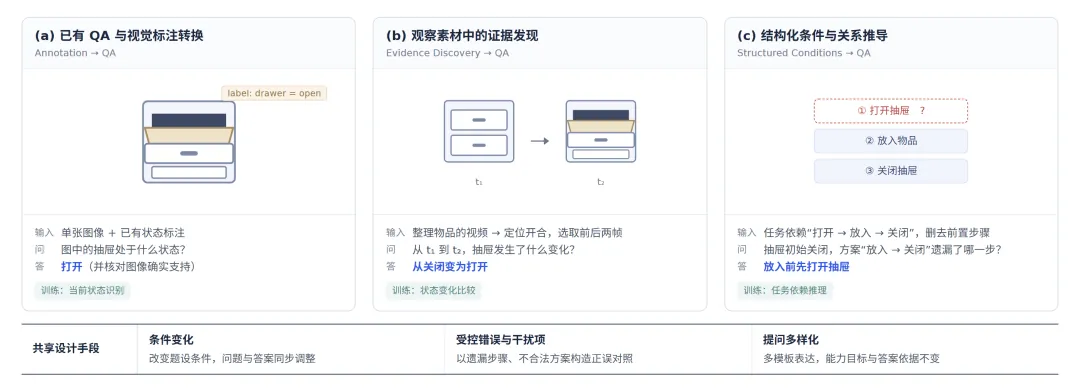
團隊把抽象能力目標逐項落實為具體訓練題,規劃場景、觀察組織、提問與判定依據,並核驗素材證據是否充分,證據不足的題目不能入庫。構題設三條可組合路徑:從既有問答轉換、從觀察素材發現證據、從結構化條件推導。
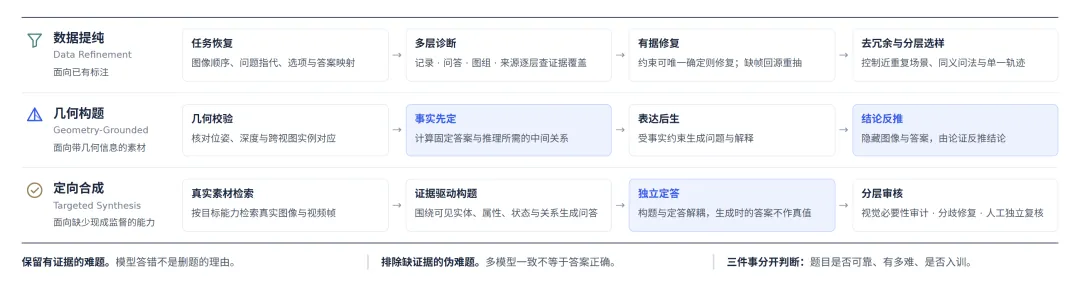
監督層面採用數據提純、幾何構題、定向合成三條互補路線,模型生成答案不直接當真值,須經獨立作答或額外審核。高難樣本由人工多視角核驗平台複核,全程遵循保留有證據的難題、排除缺證據的偽難題原則。
評測反哺數據
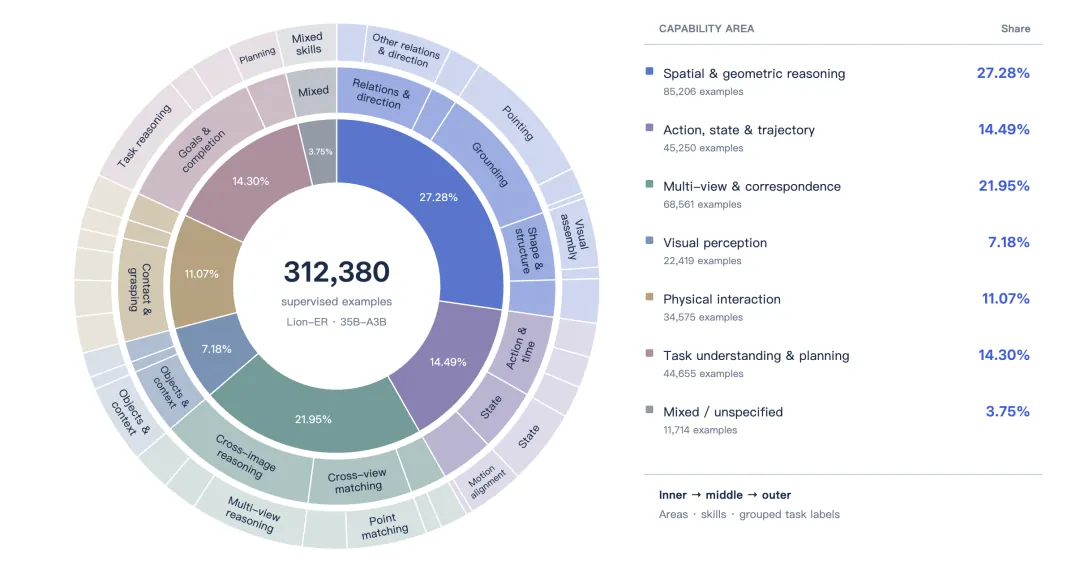
監督訓練集共 312,380 條樣本,訓練預算按能力需求而非題量分配,重點覆蓋空間幾何、多視角對應、動作軌跡與任務規劃,樣本由候選到入訓全程留痕,配方可以追溯。
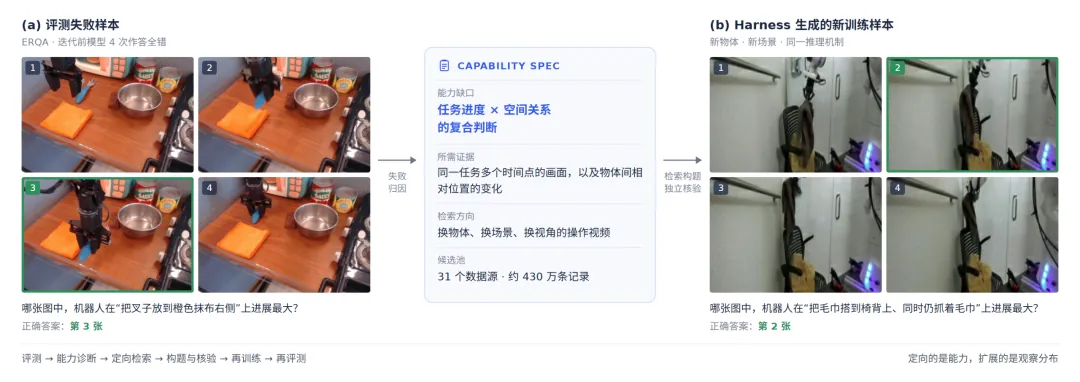
評測機制 Eval-Driven Data Harness 把錯題轉為下一輪數據需求:先核查標注與證據,區分偶發失誤與系統性缺口,再從覆蓋 31 個數據源、約 430 萬條紀錄的素材池,檢索推理邏輯相同而場景不同的新素材入訓。
例如模型曾把畫面二維上下位置等同三維高度,團隊便選用含多層可放置支撐面的場景,並為左右、前後關係加入遮擋與透視變化,令下一輪訓練直接針對失敗模式。
成績與開源
按每題作答四次取平均的 avg@4 口徑,馭物在十項公開基準的等權綜合均分達 65.29,全部高於基座。其中空間放置評測 Where2Place 得 64.28 分,較基座提升 9.30 分;具身推理基準 ERQA 得 64.38 分;空間推理 SAT 達 89.33 分。
四道公開基準案例亦顯示能力差距:判斷鏡頭轉動方向、篩選機械臂操作軌跡、跨視角定位掛畫方位及辨識任務進度,馭物均四次全對,基座與更大參數對照模型則多數出錯,反映其在相機運動、軌跡交互、空間映射與狀態識別的優勢。
模型權重已以 BF16 Safetensors 格式在 HuggingFace 開源,兼容 Transformers、vLLM、SGLang 等主流推理框架。實驗室表示,後續將拓展工具調用、多輪交互與執行反饋的訓練數據,探索長程任務的連續決策與失敗恢復。