
 IXThinker·2025-01-01 19:50
推理時運算縮放:大模型的新路徑
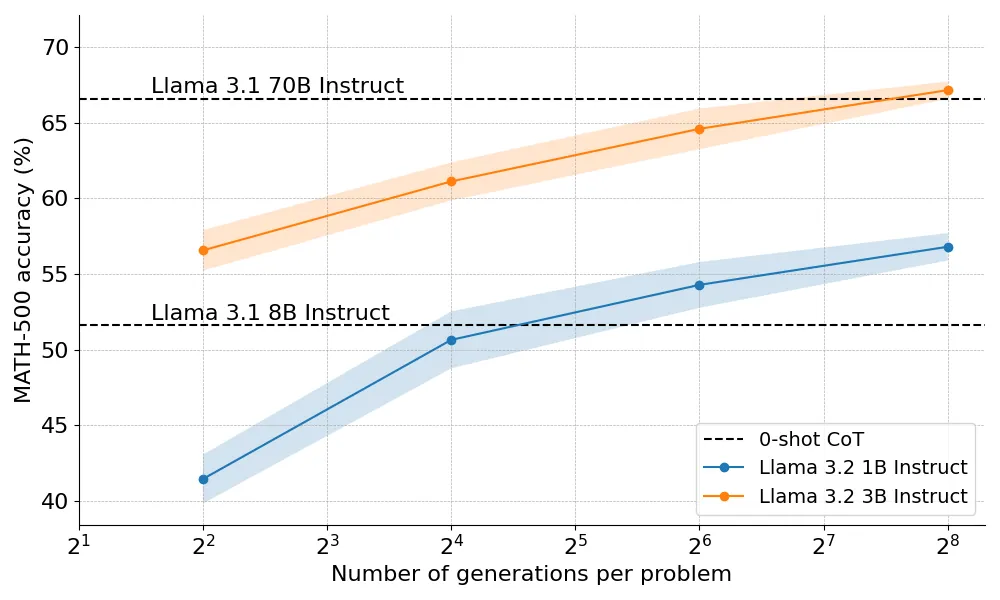
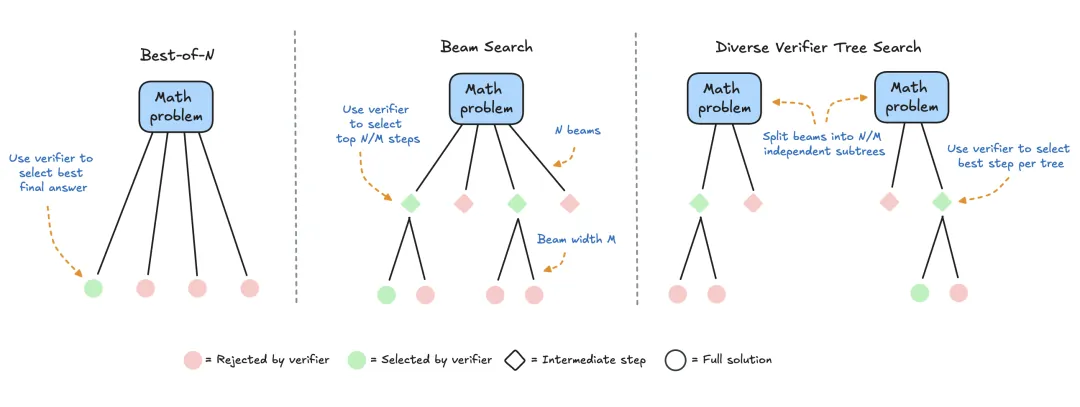
隨著預訓練成本飆升至數十億美元規模,推理時計算縮放成為大語言模型發展的互補路徑:以動態推理策略讓模型對難題「思考更久」,o1為最著名案例。
範式轉變
過去幾年LLM進程主要由訓練時計算縮放主導,此範式雖有效,但預訓練更大模型的資源異常昂貴,數十億美元規模的計算集群已經出現,促使業界尋找更經濟的互補方法。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。