
 IXThinker·2025-01-07 18:00
MetaMorph研究解讀LLM隱藏視覺能力
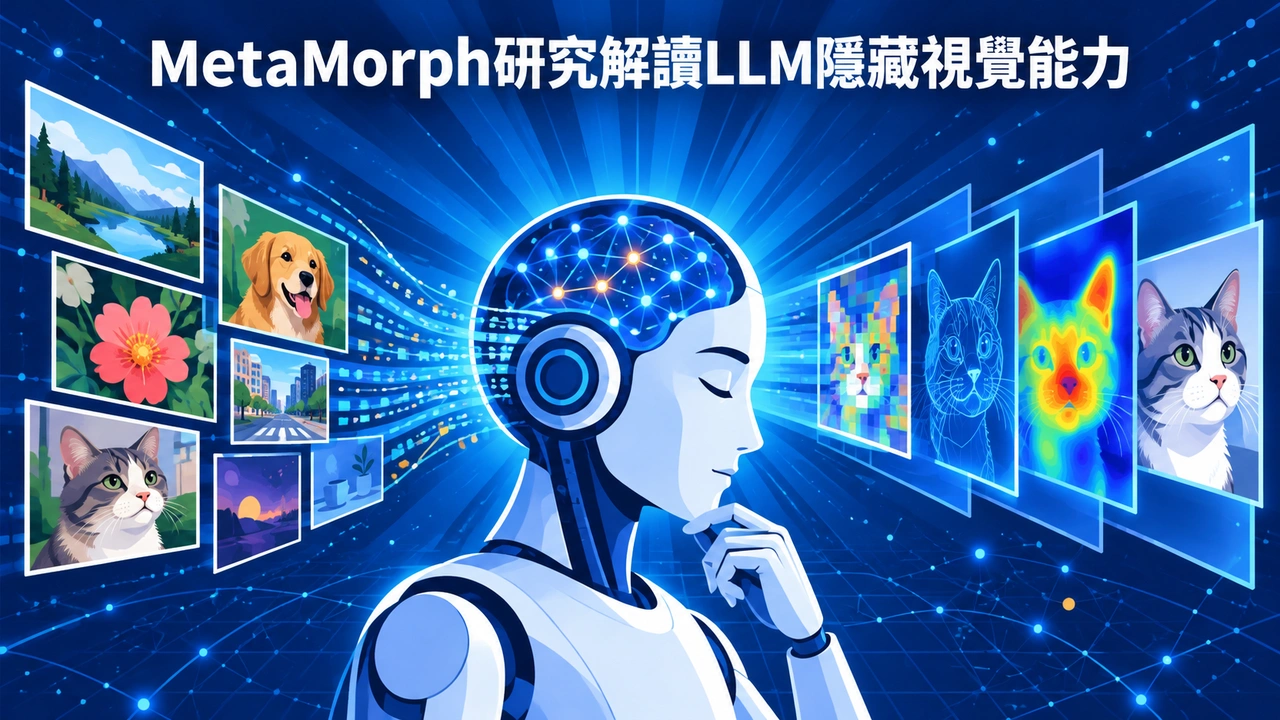
Meta與紐約大學合作的研究《MetaMorph》探索大語言模型隱藏的視覺能力,團隊將於1月9日的直播中解讀這項工作。研究提出視覺預測指令微調(VPiT),可將預訓練LLM快速轉化為統一的自回歸模型。
VPiT方法核心
VPiT把圖像與文本數據組織成指令形式的輸入序列,教會LLM同時預測離散的文本標記與連續的視覺標記,令模型獲得生成文字與圖像的雙重能力,實現從語言模型到多模態統一模型的轉變。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。