
 IXThinker·2025-01-08 12:10
7B模型勝GPT-4o 數學推理僅花一萬元
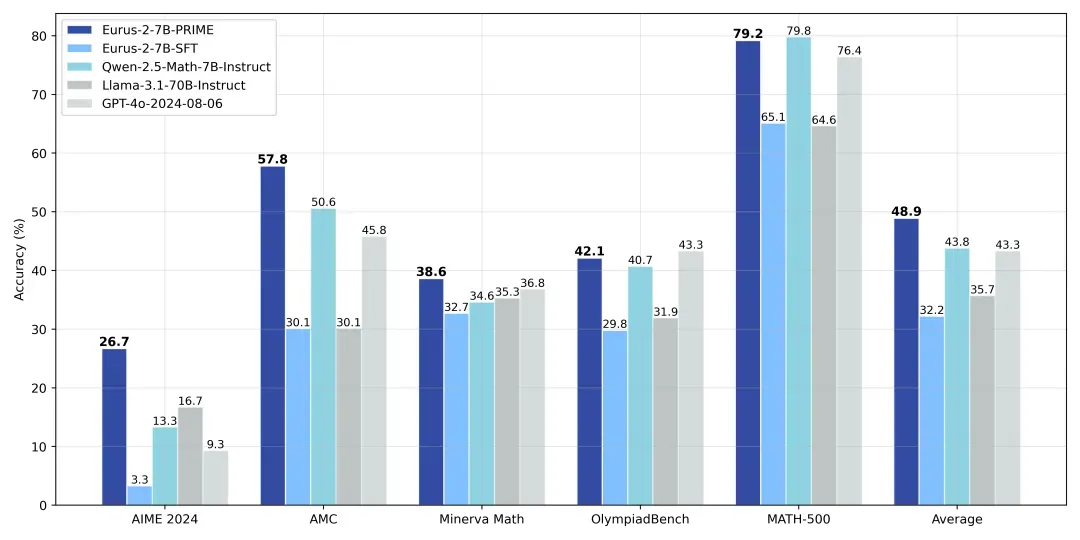
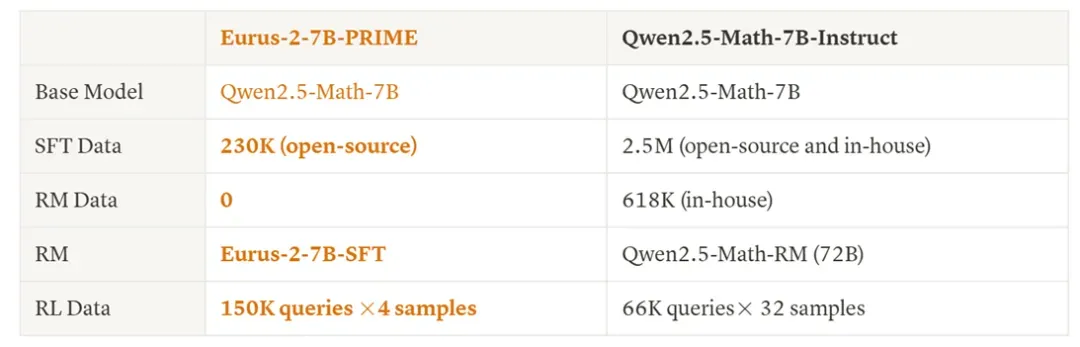
在模仿學習式擴展定律受到質疑之際,清華團隊以過程獎勵強化學習另闢路徑:不用蒸餾數據,以極低成本訓練出數學推理能力勝過GPT-4o的7B模型。
方法要點
清華大學NLP實驗室聯合上海AI Lab、清華大學電子系及OpenBMB社區提出PRIME(Process Reinforcement through IMplicit REwards),結合過程獎勵的強化學習,不依賴任何蒸餾數據與模仿學習。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。