
 IXThinker·2025-01-29 11:00
DeepSeek-R1解讀 純強化學習催生推理能力
DeepSeek-R1帶來的啟示在於:LLM的推理能力可以僅靠強化學習提升,不必依賴有監督微調;有技術社區成員撰文梳理這一新範式的要點與爭議。
純RL路線
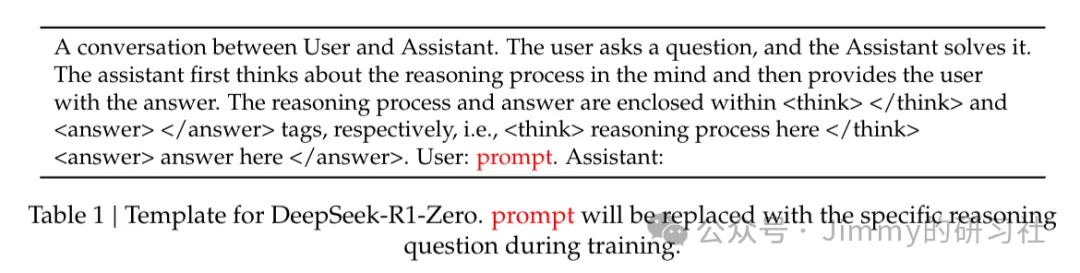
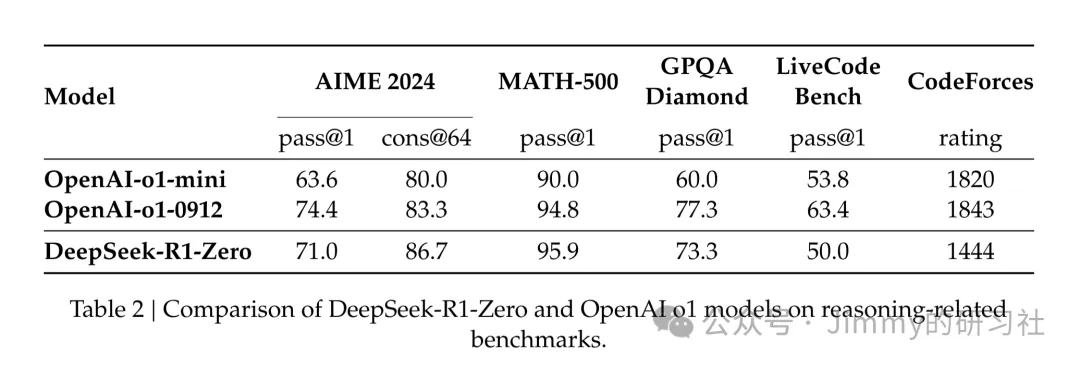
在後訓練(post-training)階段僅使用強化學習(RL)即可顯著提升模型推理能力,不再依賴有監督微調(SFT),證明LLM具有自行探索長思維鏈(COT)的能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。