
 IXThinker·2025-02-05 21:40
DeepSeek-R1拆解 強化學習練出推理能力
DeepSeek-R1是DeepSeek團隊的第一代推理模型,透過強化學習與蒸餾技術顯著提升語言模型的推理能力。相關技術路線與訓練策略,為業界提供極具參考價值的範本。
Zero無監督起點
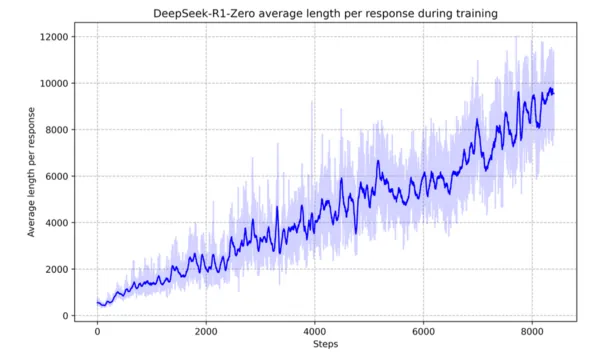
DeepSeek-R1-Zero在沒有監督微調的情況下,僅靠大規模強化學習訓練便展現強大推理能力,證明純強化學習路線的潛力;但模型存在可讀性差、語言混雜等問題,距離實用仍有距離。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。