
 IXThinker·2025-02-10 08:50
WorfBench評測智能體 18主流模型全不及格
浙大與通義團隊在ICLR 2025發表WorfBench,針對大模型智能體拆解複雜任務、生成可執行工作流的核心能力建立評測基準,18個主流大模型在測試中全數不及格。
智能體演進
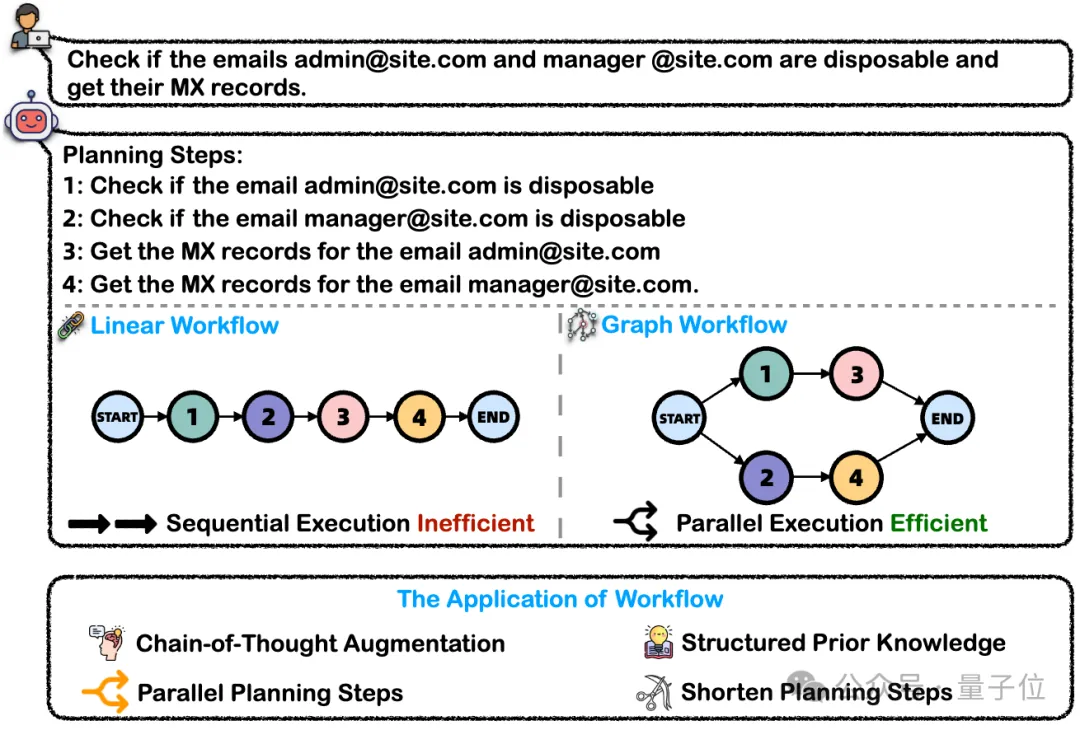
大模型智能體能力已不限於API調用,OpenAI的Operator與Anthropic的Computer Use等都能像人類一樣直接與界面交互、執行複雜操作;把複雜問題分解為可執行工作流,是完成任務的關鍵一步。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。