
 IXThinker·2025-02-13 14:40
測試時擴展新策略 1B模型表現超405B巨無霸
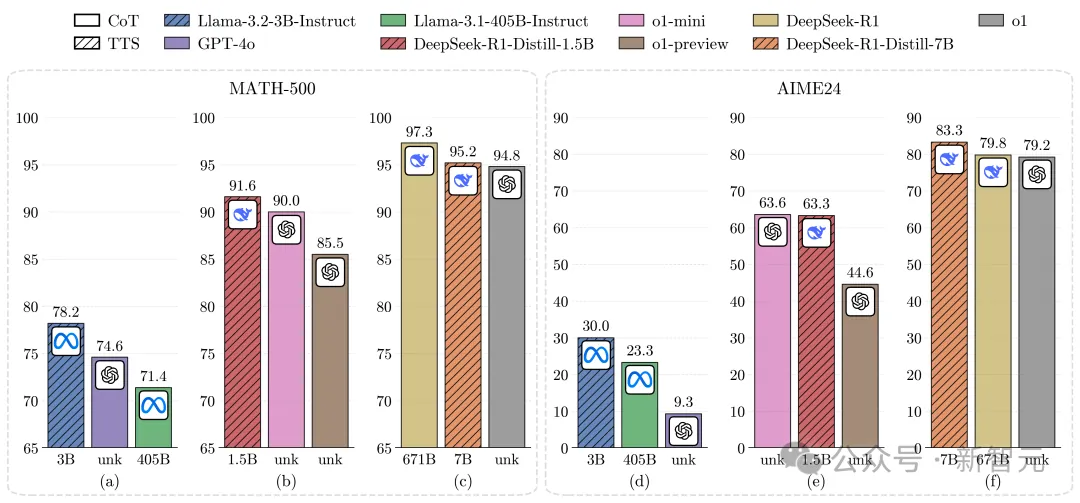
一篇多機構聯合發表的論文在AI圈引起轟動:透過重新思考計算最優的測試時擴展(TTS),1B參數模型竟能超越405B巨無霸。研究證明策略得宜下小模型性能可大幅反超,為「愈大愈好」的觀念帶來反思。
TTS成最新範式
OpenAI o1已證明,測試時擴展可透過在推理時分配額外算力,大幅增強大語言模型的推理能力,測試時計算亦成為提升模型性能的最新範式。但不同策略模型與獎勵模型如何影響效果,一直缺乏系統答案。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。