
 IXThinker·2025-02-17 12:50
滬團隊純強化學習煉模型 數學推理媲美O1
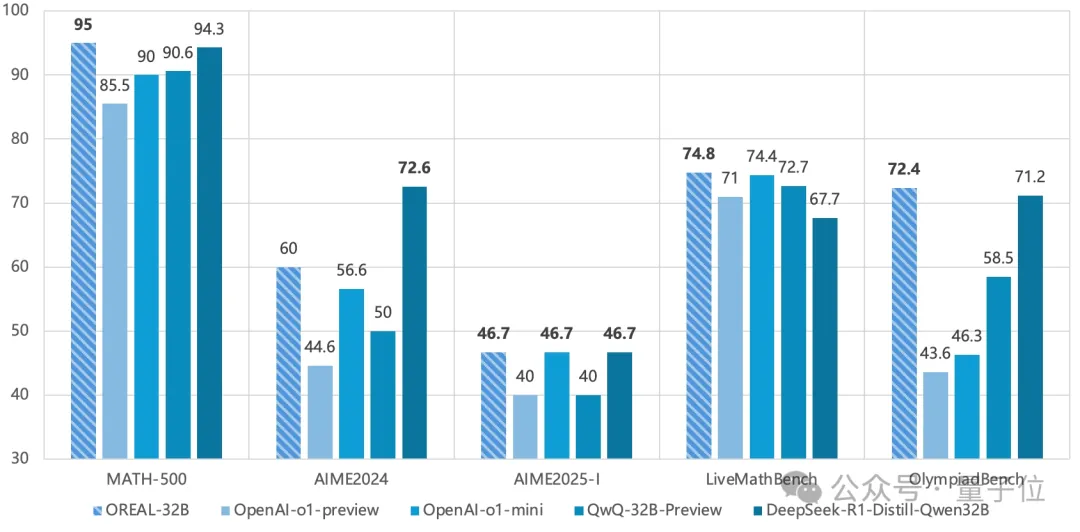
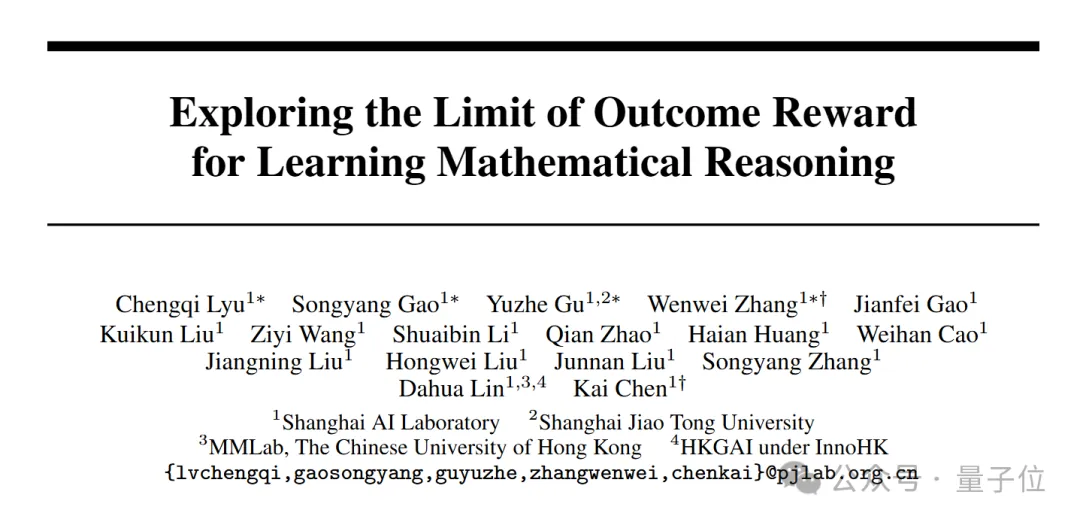
上海AI Lab提出基於結果獎勵的強化學習新範式,不靠蒸餾DeepSeek-R1,僅以微調加強化學習即令32B模型數學推理追平頂級模型表現。
三重門困局
團隊總結當前大模型數學推理面對三重困局:最終答案對錯的二元反饋令複雜推理難以優化;長思維鏈中局部正確的步驟反可誤導模型學習;傳統蒸餾路線則令研究者陷於參數規模依賴。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。