
 IXThinker·2025-02-20 13:00
VideoRoPE把RoPE擴展至影片理解檢索
廣泛應用於Llama等模型的旋轉位置編碼RoPE如今有了影片版本:復旦大學、上海人工智能實驗室等機構提出VideoRoPE,令長影片理解與檢索能力顯著增強。
四項關鍵特性
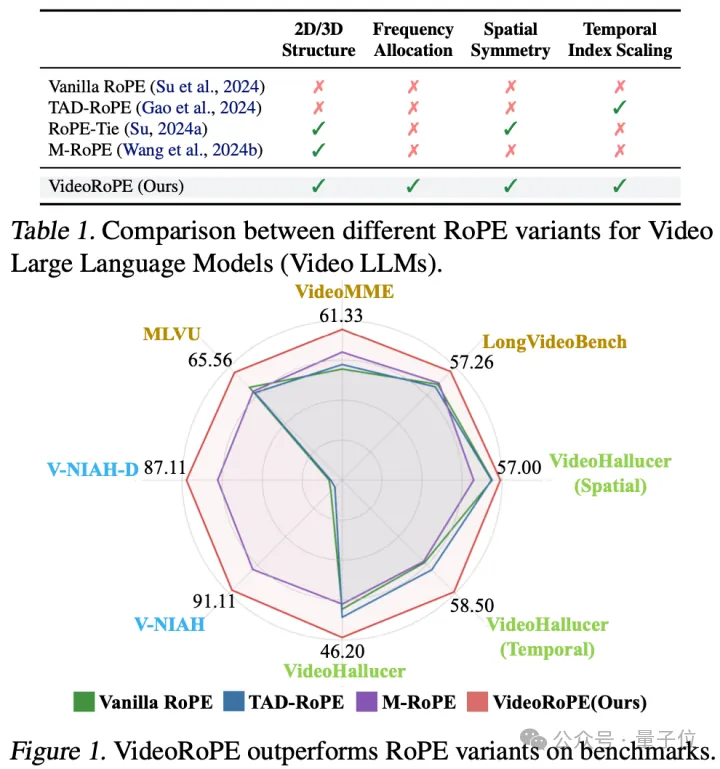
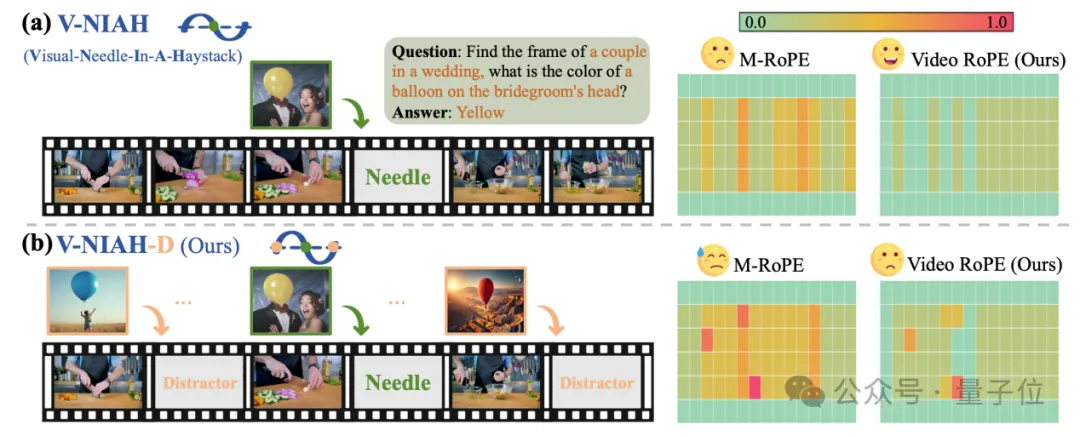
RoPE能把相對位置資訊融入self-attention,提升transformer性能,但一維形式難以直接套用到時空結構複雜的影片;團隊確定了將RoPE有效應用於影片所需的四個關鍵特性。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。