
 IXThinker·2025-02-22 23:50
清華推Migician 視覺定位由單圖拓展至多圖
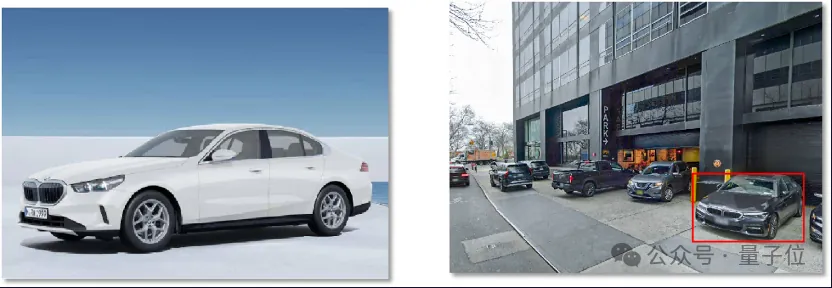
多模態視覺定位能力迎來升級:清華團隊推出Migician,把定位範圍由單張圖像拓展至多圖場景,無論在相冊中找人、跨圖找同款車,都能直接輸出精確座標。
由單圖到多圖
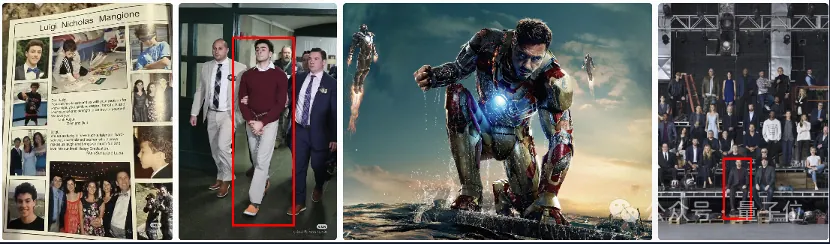
以往視覺定位多限於單張圖像,Migician把能力延伸至多圖應用場景。例如在複雜相冊中辨認出Luigi並於第二張圖中鎖定他,或根據「鐵甲奇俠」劇照,在合影中精準找到對應的演員唐尼。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。